2012 年,多倫多。
一間普通住宅的臥室裡,
兩張顯示卡日夜不停地轉。
我們今天用的各種 AI,幾乎都可以追溯到這個房間。
這趟旅程要回答的問題
這段歷史可以從幾個問題出發。第一個問題很古老:人類從什麼時候開始想像「會思考的機器」?早在電腦出現之前,人們就透過神話、傳說與精巧的機械,反覆想像人造的生命。第二個問題比較抽象:「思考」這件看不見的事,是怎麼一步步被轉寫成可以一步步執行的「計算」,最後交給機器去做。
接著要面對的是挫折。AI 並不是一路順遂,它經歷過兩次「寒冬」,也就是期待落空、資金與關注大量撤離的低潮期,差點被整個學界放棄。理解寒冬的成因,才看得懂後來的轉折:2012 年一間臥室裡發生的事,為什麼會成為深度學習崛起的起點;而從 AlexNet 到 ChatGPT 只隔了十年,進展為什麼突然變得這麼快。
最後一個問題留給讀者自己:回頭看完這段歷史,對正在使用 AI 的我們有什麼啟示?帶著這些問題往下讀,每一段故事都會變成回答的線索。
路線圖
貫穿全篇的三條線索
AI 的歷史人物與事件很多,容易讀到後面忘了前面。一個實用的方法,是用三條線索來整理每一段故事。
第一條是想像:人類如何想像「會思考的東西」。神話、小說與電影往往走在技術前面,先提出願景與恐懼,技術才慢慢追上。第二條是方法,也就是兩大路線的拉鋸。符號派主張把規則一條條寫給機器,讓它依規則推理;連結派則主張給機器大量例子,讓它自己從中找出規律。兩派的消長,幾乎決定了 AI 每個時期的面貌。
第三條是條件:理論、資料、算力、資金與人才。這五樣缺一樣,再好的想法也跑不起來。許多看似失敗的構想,其實只是條件還沒到位。讀每一段歷史時,不妨問自己:這三條線各自走到了哪裡?
想像
人類如何想像「會思考的東西」:神話、小說、電影,常常走在技術前面。
方法
兩大路線的拉鋸:符號派(把規則寫給機器)vs. 連結派(讓機器從例子學)。
條件
理論、資料、算力、資金、人才——缺一樣,再好的想法也跑不起來。
古代的夢:會動的機器
西元前 – 18 世紀
在電腦出現前兩千年,人類就想造出「像活的」東西
塔羅斯 Talos:希臘神話的青銅巨人
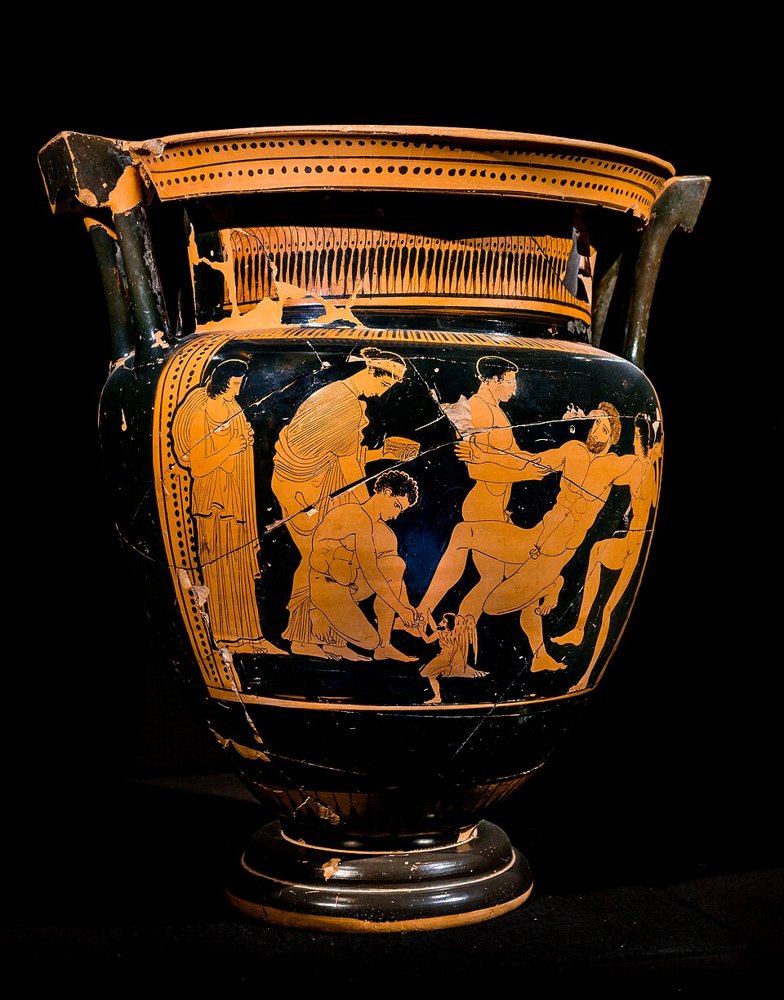
在希臘神話裡,火神赫菲斯托斯打造了一個青銅巨人塔羅斯,讓它每天繞著克里特島走三圈,守護整座島嶼。圖中這位巨人不是血肉之軀,而是工匠的作品,被造出來就是為了執行一項明確的任務。
神話對它的身體描寫得很具體:全身只有一條「血管」,從頭通到腳踝,末端用一根釘子封住。後來女巫美狄亞拔掉這根釘子,裡面的「生命」流光,巨人便倒下了。這個細節很有意思,它把生命想像成一套可以被打開、也可以被關掉的機關。
塔羅斯是人類最早的「人造守衛」想像之一:有任務、會行動,但沒有自己的意志。神話裡的機器人大多是這樣的工具,被造出來、聽命行事。這種想像一直延續到今天,人們對 AI 的期待與恐懼,很多仍圍繞著「它是聽話的工具,還是會脫離掌控」打轉。
偃師造人:《列子·湯問》的故事
《列子·湯問》記載了一則故事:周穆王西巡時,一位名叫偃師的工匠獻上一個「倡者」,也就是會表演的人偶。這個人偶能唱歌跳舞,舉手投足都和真人一樣,甚至對穆王的妃子眉目傳情。穆王大怒,要殺偃師。
偃師當場把人偶拆開,裡面全是皮革、木頭、膠漆與顏料。更妙的是,拆掉心臟它就不能說話,拆掉肝它就看不見。故事把人的各種能力對應到一個個零件上,等於把功能拆解成零件,這正是後來工程與科學看待複雜系統的方式。
要提醒的是,這是傳說,不是史實。但它很早就問出一個現代問題:「像人」和「是人」差在哪裡?今天的聊天機器人在對話中表現得很像人,拿它和偃師的人偶相比,有哪些相同、哪些不同,是個值得思考的對照。
亞歷山卓的希羅
Hero of Alexandria約西元 10–70 年
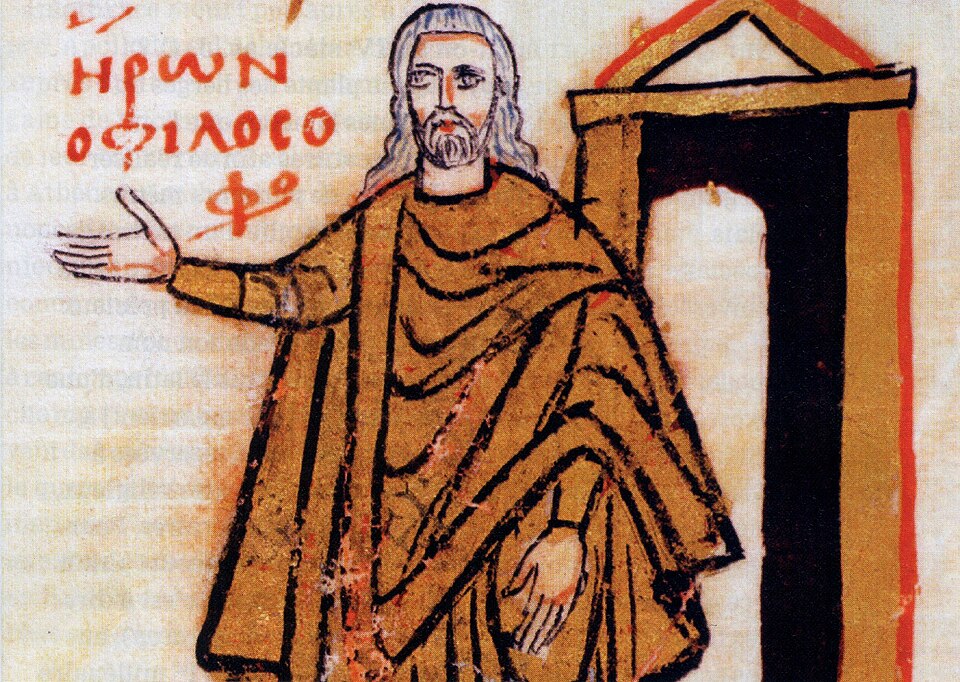
希羅是西元 1 世紀的古希臘工程師與數學家,留下《自動機》等著作,記錄了許多巧妙的自動裝置。他設計過汽轉球(又稱蒸汽球),也做出投幣就會流出聖水的販賣機,以及會自動開啟的神殿大門。
他最常被後人提起的作品,是「自動劇場」與自動推車。做法是把繩子纏繞在轉軸上,重物下降時拉動繩子帶動轉軸;繩子在哪裡纏幾圈、往哪個方向繞,就決定了機器先做什麼、再做什麼、何時停下。
因此希羅的機器常被稱為最早的「可程式化」機器,意思是機器要做的事可以事先安排好。什麼是「程式」?可以把它想成一份食譜:先做什麼、再做什麼、做到哪裡停下,事先一步一步寫好;照著做的人不必自己判斷,依序執行就好。繩子的纏法,就是程式:繩子怎麼纏,機器就照著那個順序動作。
今天的電腦也一樣。工程師用文字把步驟一條一條寫下來,這些文字叫做程式碼,電腦再依序執行。工具不同,但「先把步驟寫好,再交給機器執行」的想法是相通的。
安提基特拉機械:兩千年前的類比計算機
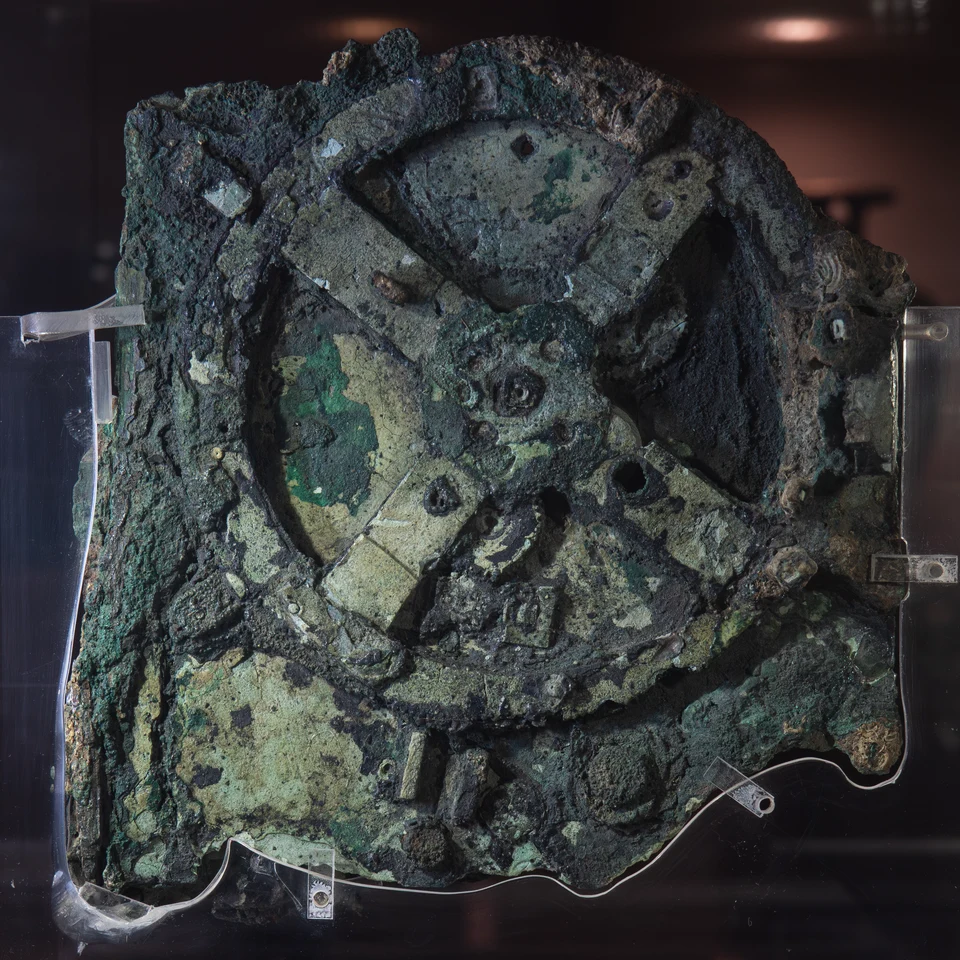
1901 年,人們從希臘的一艘沉船中撈起一團鏽蝕的青銅,年代約在西元前 2 世紀至前 1 世紀之間。後來的研究發現,它是由至少 30 個青銅齒輪組成的精密裝置,可以推算太陽與月亮的位置、月相變化,甚至預測日食與月食。
由於外觀殘破,內部構造主要是靠 X 光斷層掃描才逐漸被看清楚。研究之後,它被普遍稱為已知最早的「類比計算機」。
「類比」(analog)是什麼意思?先看一個生活中的例子:指針式手錶。錶面上並沒有寫著「三點」這兩個字,而是讓指針轉到某個位置,我們看指針指在哪裡,就知道現在幾點。指針的位置「比擬」了時間,這就是類比。
安提基特拉機械也是這樣運作的。轉動把手,齒輪跟著轉,盤面上的指針就會指向某個位置,代表那一天太陽或月亮在天空中的哪裡。機器不必寫下任何數字,答案就在指針指的位置上。
和類比相對的是「數位」(digital),也就是今天電腦的做法:把一切都換成數字來計算。數字手錶就是數位的,直接顯示「3:00」這樣的數字。
它帶來的啟示是:把天體運行的規律「刻」進齒輪的比例裡。只要齒數比例設計正確,轉動把手,答案就會自己出現。知識不再只存在人的腦中,而是被固定在機器的結構裡。
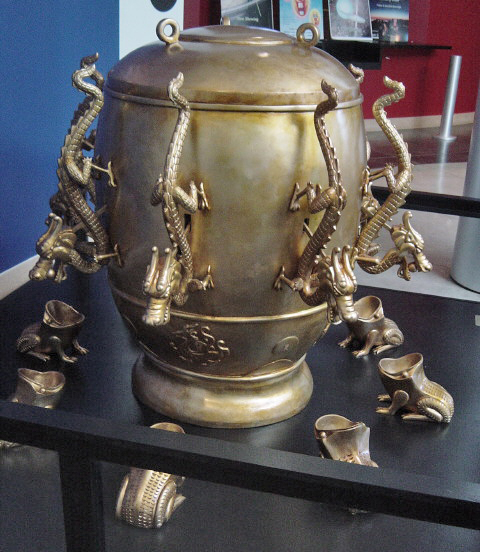
張衡與候風地動儀
Zhang Heng西元 78–139 年
東漢科學家張衡在西元 132 年製作了候風地動儀。需要先說明,圖中是後人製作的復原模型,不是原物。地動儀的內部構造早已失傳,各家提出的復原方案至今仍有爭議。
史書記載過一次事件:某天地動儀的銅丸落下,京城裡卻沒有人感覺到震動;幾天後,隴西的驛使趕來通報,當地發生了地震。這段記錄讓地動儀成為古代偵測遠方地震的著名例子。
地動儀當然不會「思考」,但它能感測環境、自動做出反應:外界有了變化,裝置便以落下銅丸作為回應,不需要人在旁邊判斷。這種「感測、再反應」的循環,正是後來控制論的核心概念,也是今天許多自動化系統的基本骨架。
蘇頌水運儀象台:會自己報時的天文鐘塔
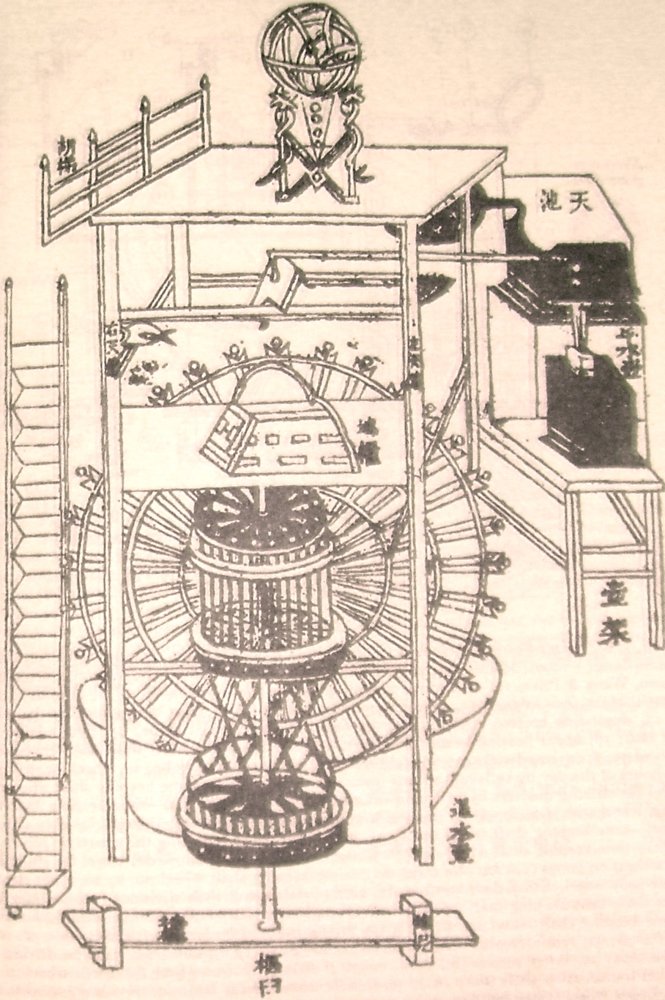
北宋時期,蘇頌主持建造水運儀象台,1088 至 1092 年間在開封完成,高約 12 公尺。它是一座結合天文觀測與報時功能的鐘塔:以水力作為動力,上層有觀測天體用的渾儀,中層有展示星空運轉的渾象,下層則有會在固定時刻出來報時的木人。
要讓水力穩定地推動整座儀器,關鍵在於控制轉速。水運儀象台使用了類似「擒縱機構」的裝置,讓動力不是一口氣釋放,而是一格一格地、有節奏地推進。這個設計被李約瑟視為機械鐘的先驅。
從這座鐘塔可以看到三個要素的結合:規律、動力、自動執行。天體運行提供規律,水力提供動力,機構負責把規律一步步執行出來。機器開始替人承擔重複性的工作,人不必再守在一旁計時。
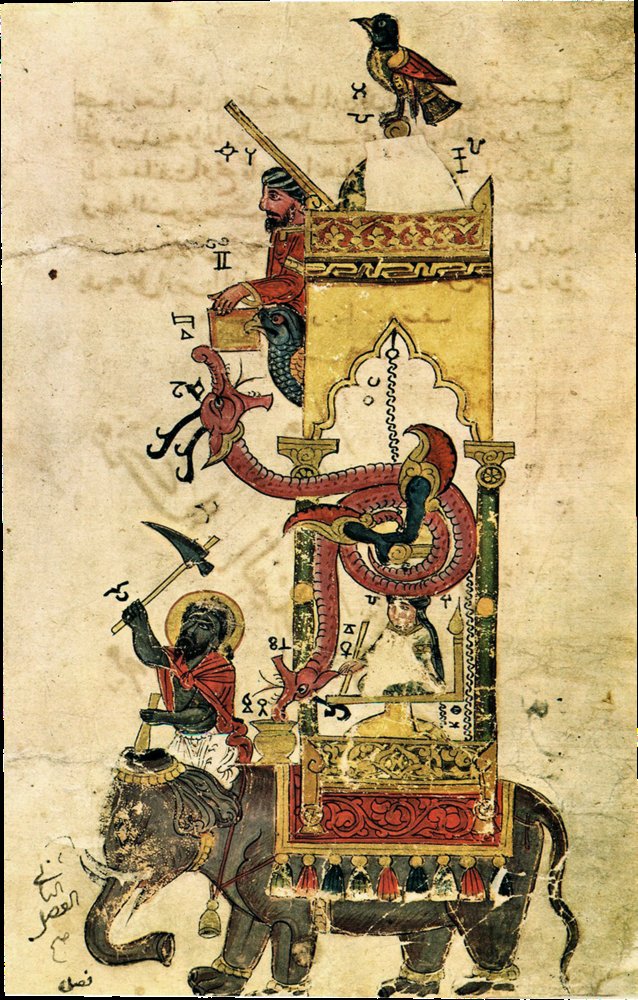
加札利
Ismail al-Jazari1136–1206 年
加札利是伊斯蘭黃金時代的工程師,1206 年完成《精巧機械裝置知識之書》。書中記載了上百種裝置,包括大象鐘、自動洗手器,以及會演奏音樂的機器樂隊。圖中就是書裡的大象鐘插圖。這本書不只是作品目錄,而是一部完整的工程手冊,有圖有步驟,讓後人可以照著製作。
其中最值得注意的是機器樂隊。樂隊的鼓手由凸輪帶動(凸輪是一種會轉動的輪子,輪子轉一圈,上面凸起的地方就會推動旁邊的機件一下),凸輪上插著木樁,轉到木樁時就敲一下鼓。只要更換木樁的位置,就能改變演奏的節奏。
換木樁,其實就是換程式。鼓還是那面鼓,凸輪還是那個凸輪,機器本身沒有改變;改變的只是木樁的位置,也就是交給機器的步驟。同一台機器,因此能演奏不同的節奏。
這就像同一台鋼琴,換一份樂譜就能彈出不同的曲子。機器本身(鋼琴)叫做「硬體」,交給機器的步驟(樂譜)叫做「程式」。加札利的機器樂隊,正是硬體與程式分開的雛形:與其為每首曲子造一台新機器,不如造一台可以重新設定的機器。今天的手機也是如此,同一支手機裝上不同的 App,就能做完全不同的事。
自動機的黃金年代(17–18 世紀)
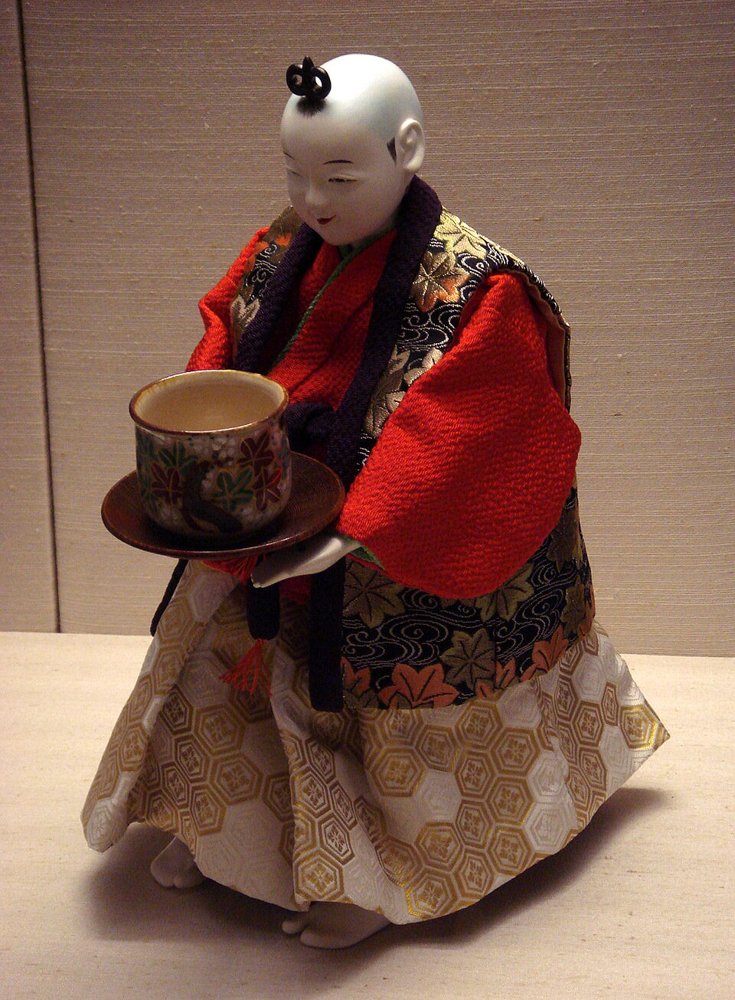
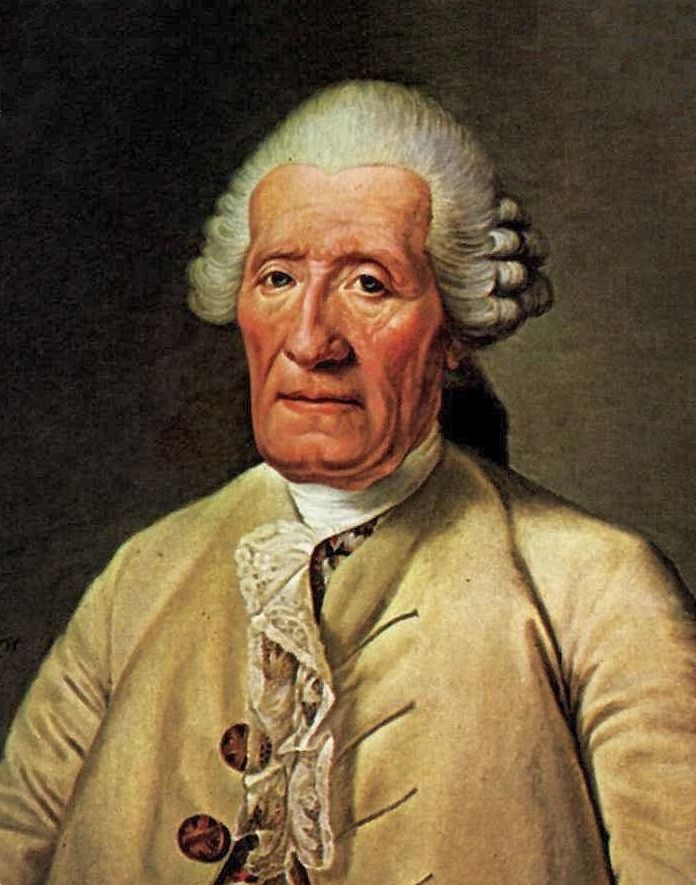
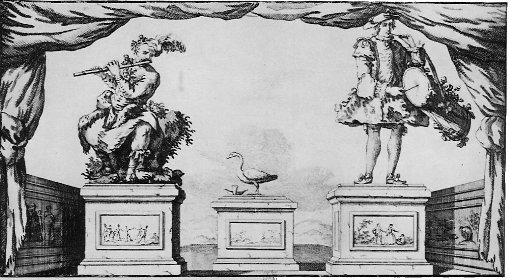
這些機器讓觀眾驚嘆「像活的一樣」,但它們都只是精巧的發條與凸輪。
機關人偶的現代版:替你抽籤的機器
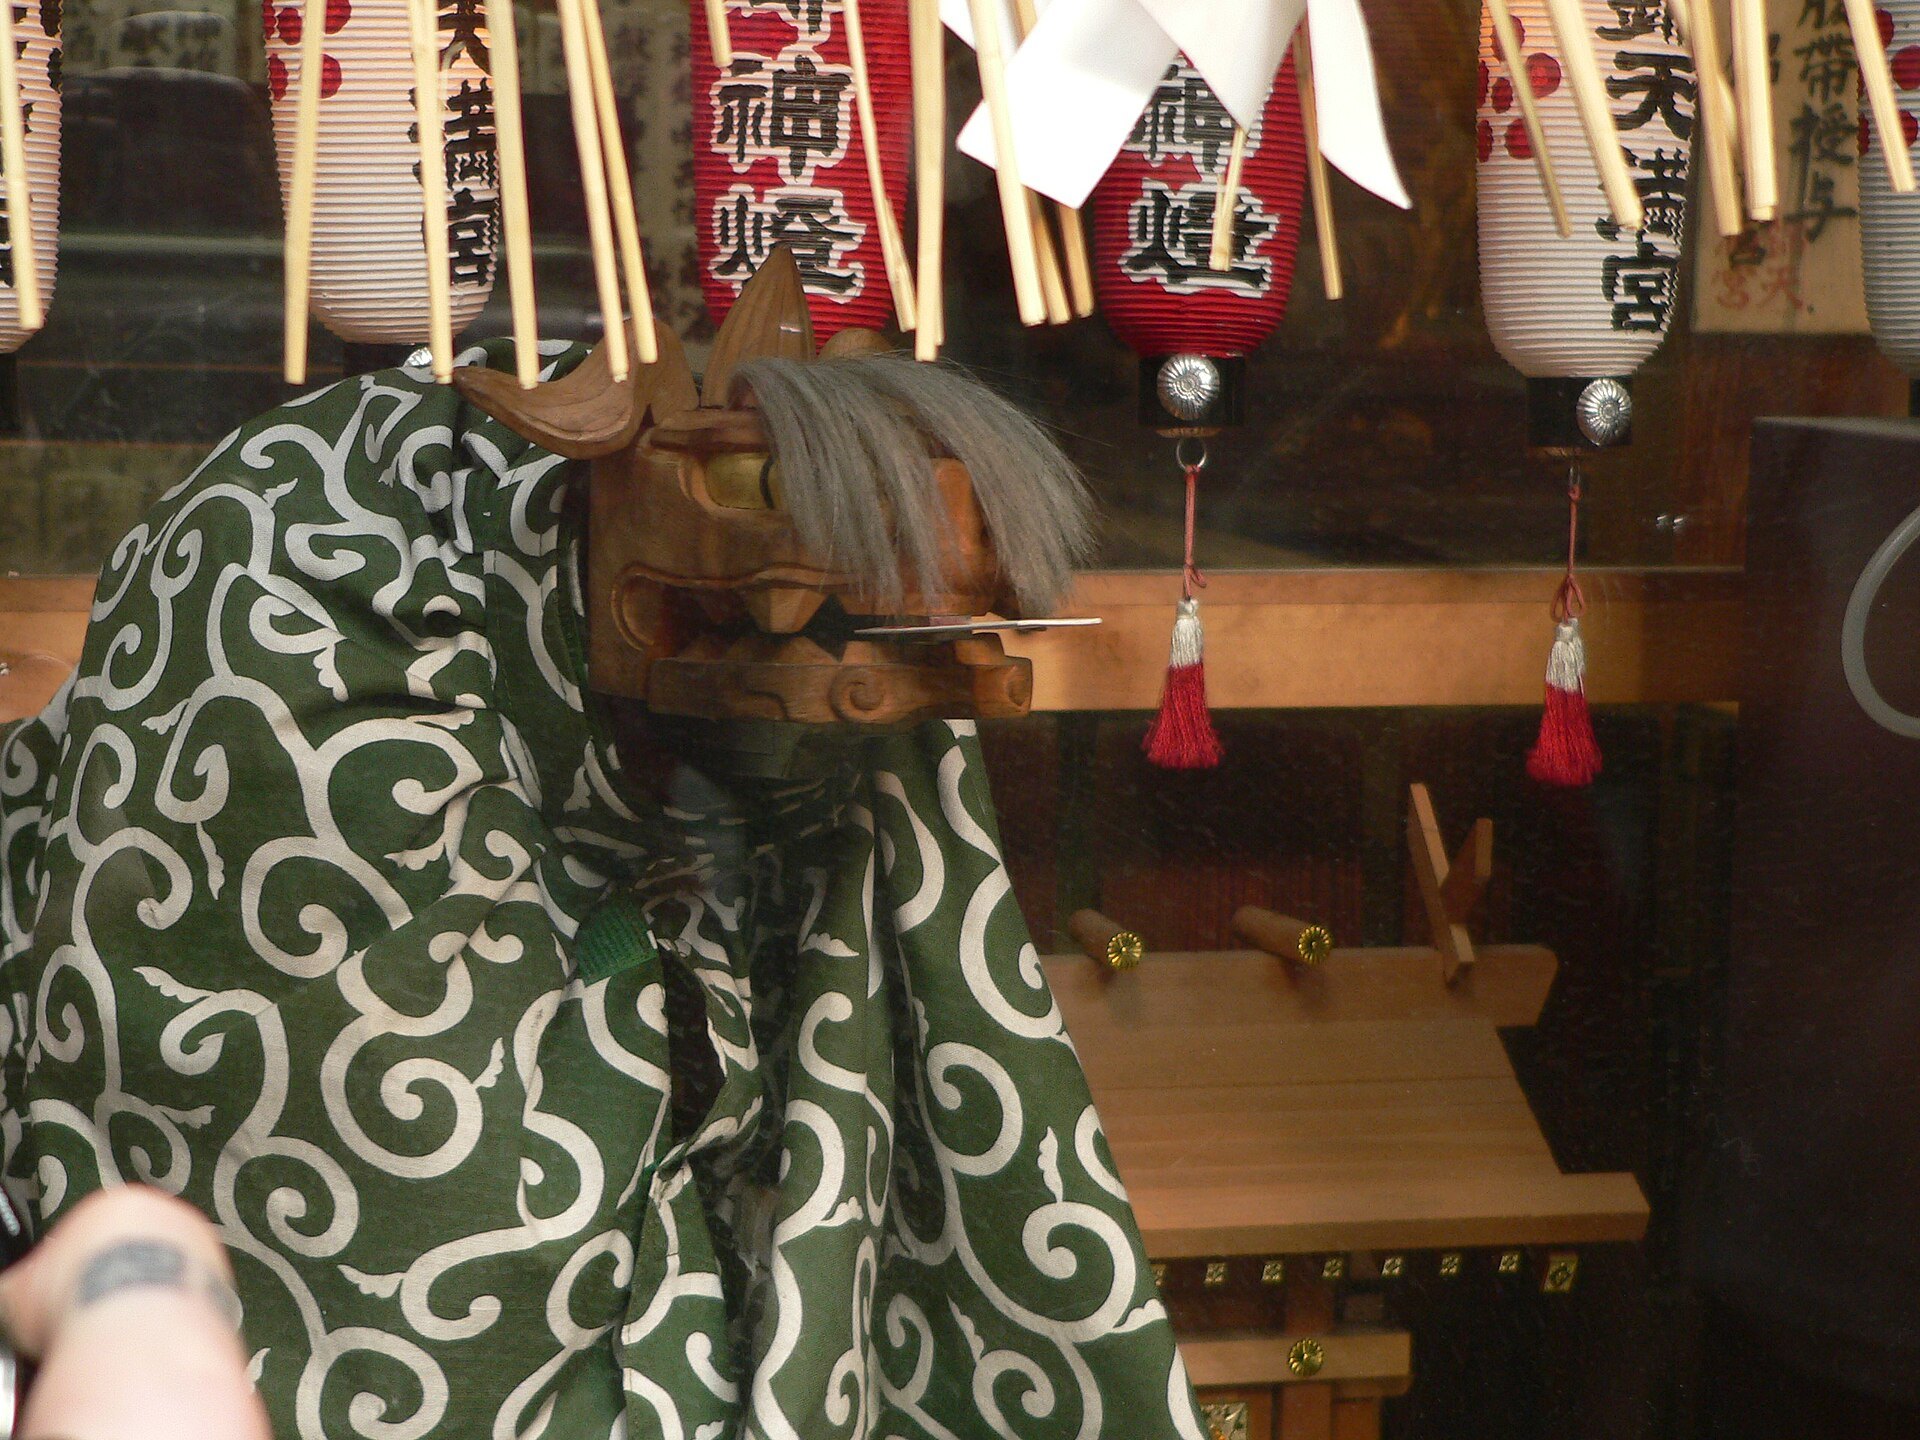
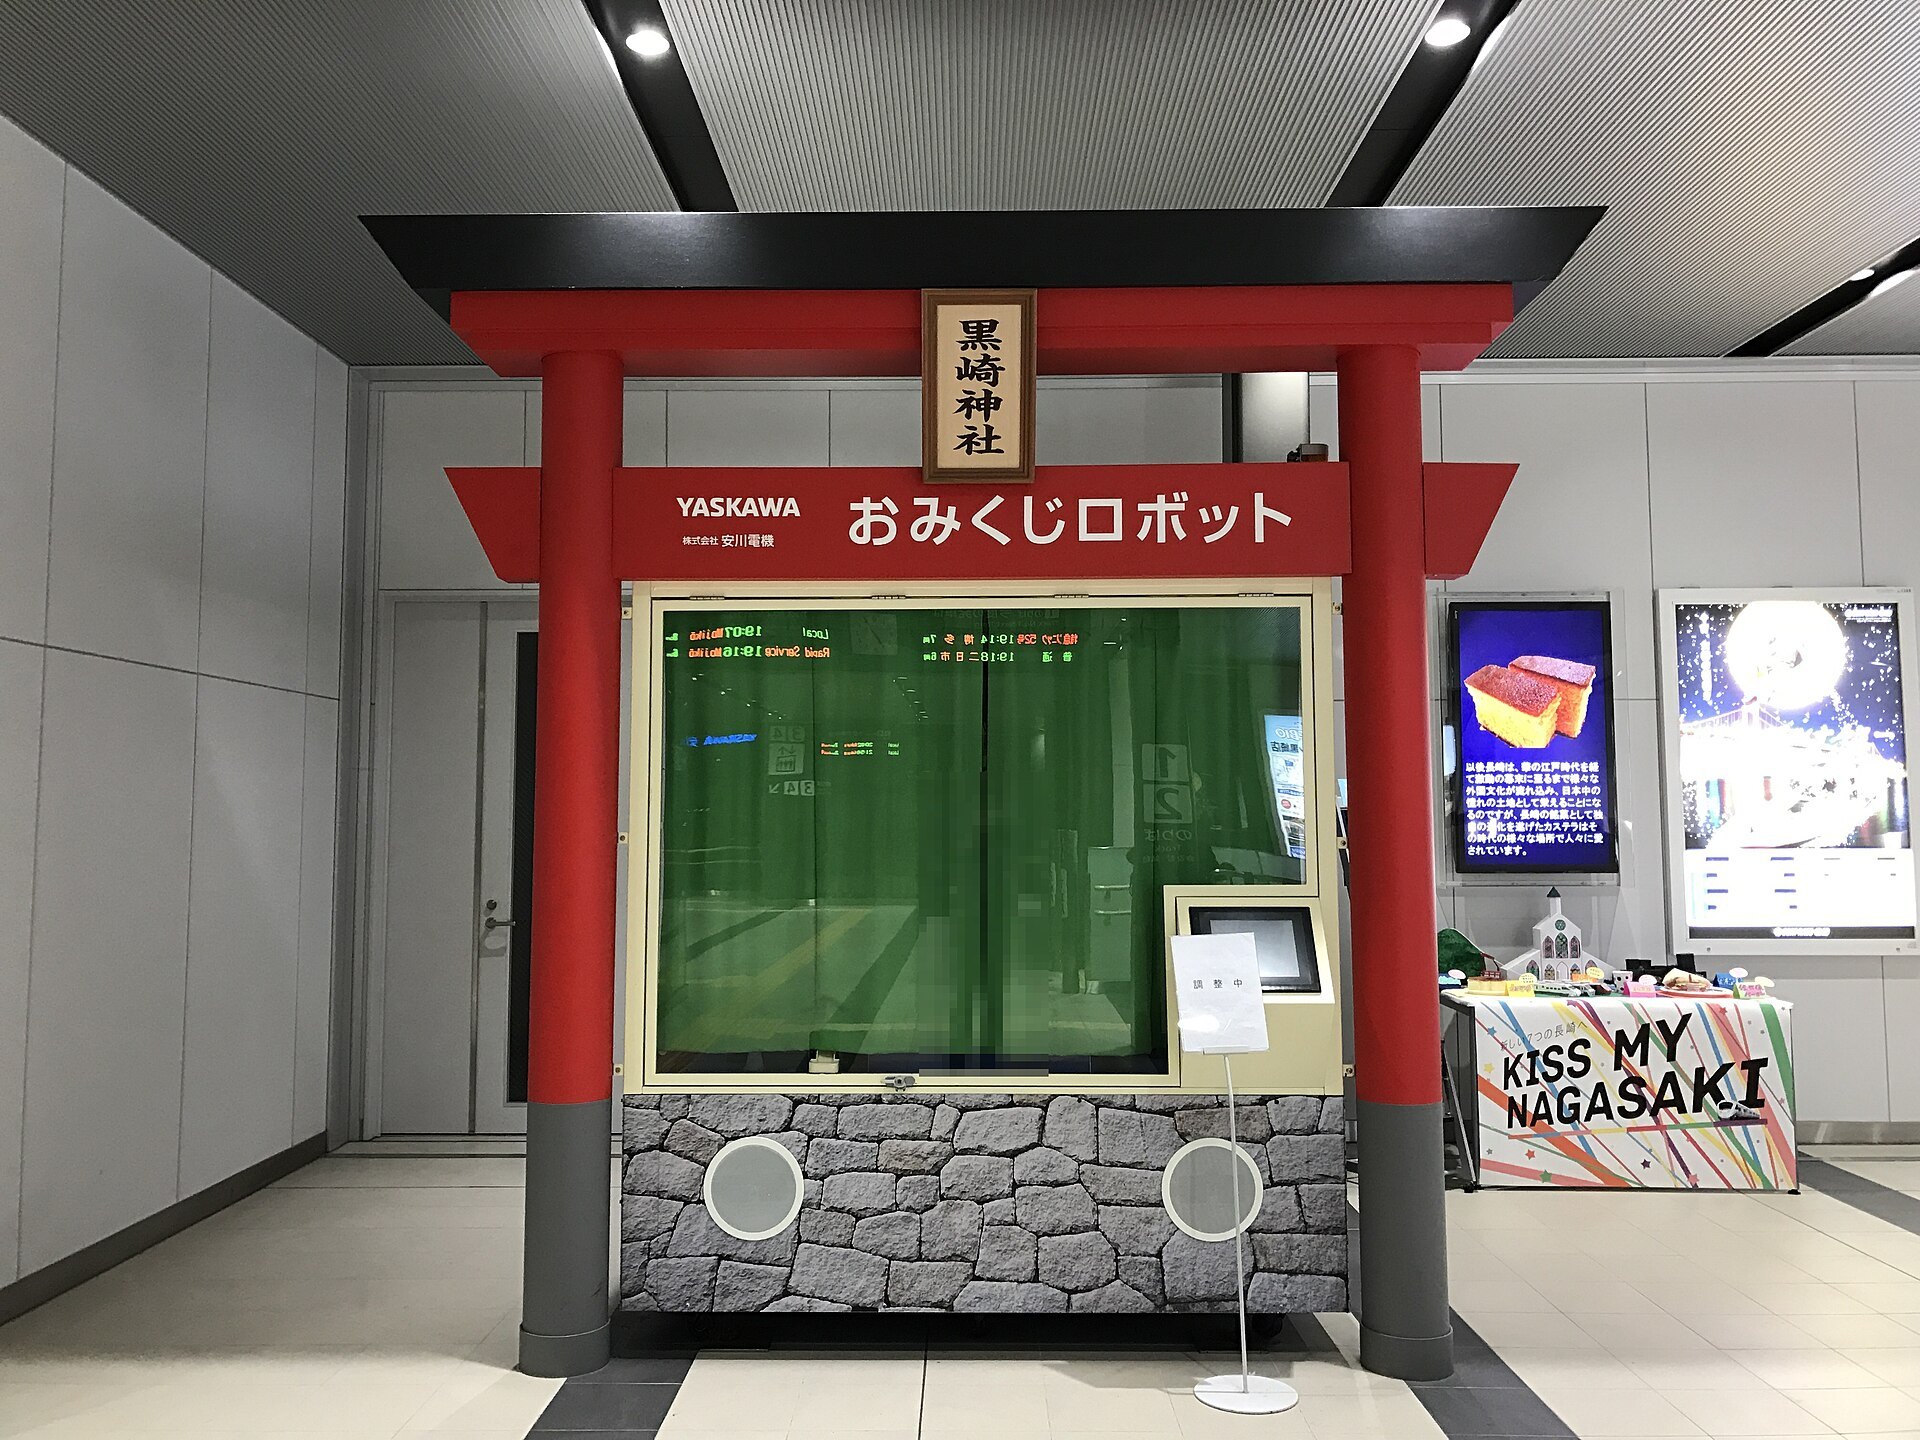
有人靠近就奏樂、投了錢就取籤:外型像人或像獅子,動作仍是事先設計好的「感測、再反應」。
消化鴨:一場精心設計的魔術
1739 年,沃康松展出一隻機械鴨。它會拍動翅膀、喝水、吃下穀粒,最後還會「排泄」。看過的觀眾大多以為,這隻鴨子真的能在體內消化食物,機械已經可以模仿生命最基本的作用。
後來真相被揭穿:穀粒只是進入一個容器存放起來,排出的「排泄物」是事先藏好的。從外面看,吃進與排出的過程一應俱全,內部卻根本沒有發生消化。
這個故事的啟示是:外表的行為很像,不代表內部真的在做那件事。同樣的問題在今天換了形式出現:AI 能寫出看起來很像理解的回答,但它真的「理解」了嗎?判斷一個系統的能力,不能只看輸出的表面,也要追問它是怎麼產生這些輸出的。
這張「內部構造圖」,其實是想像的
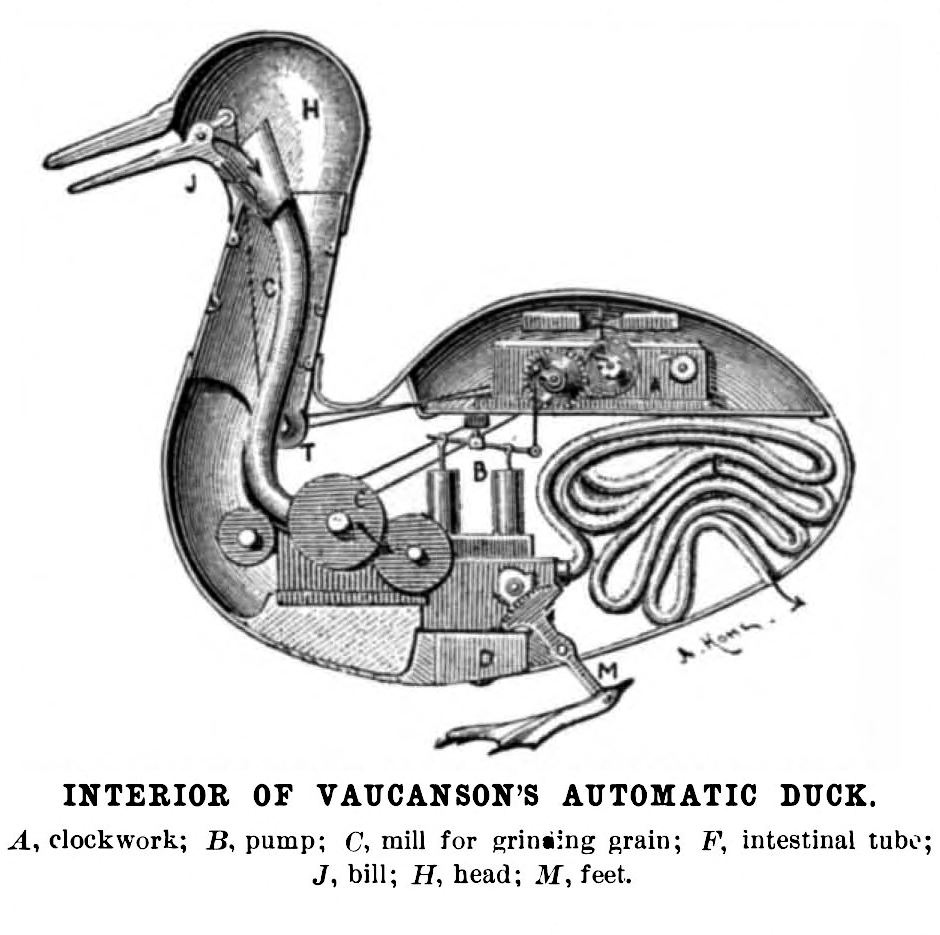
上一張提到消化鴨的祕密。你在網路上搜尋「消化鴨」,很可能會看到這張圖:鴨子身體裡畫著一條管子,從嘴巴一路通到尾巴,看起來就像真的有一套消化系統。這張圖常被當成消化鴨的內部構造,到處轉載。
但它其實是美國雜誌《Scientific American》在 1899 年刊出的想像圖,距離 1739 年消化鴨展出,已經過了一百六十年。英文維基百科在這張圖的說明裡,直接稱它是一張「錯誤的」圖。真正的消化鴨並沒有這條管子:1844 年,法國魔術師羅貝爾-烏丹(Robert-Houdin)檢查過消化鴨,發現排出的「糞便」是事先做好、染成綠色的麵包屑丸子。消化鴨的原物,據信在 1879 年一場私人博物館的火災中毀損,今天已經無法再打開來看。
這張圖本身就是一個查核的例子。一張畫得很仔細、流傳很廣的圖,看起來就像證據,但它可能只是後人的想像。看到圖片時,也要追問:這張圖是誰畫的?什麼時候畫的?畫的人真的看過實物嗎?
「土耳其行棋傀儡」:會下西洋棋的機器?
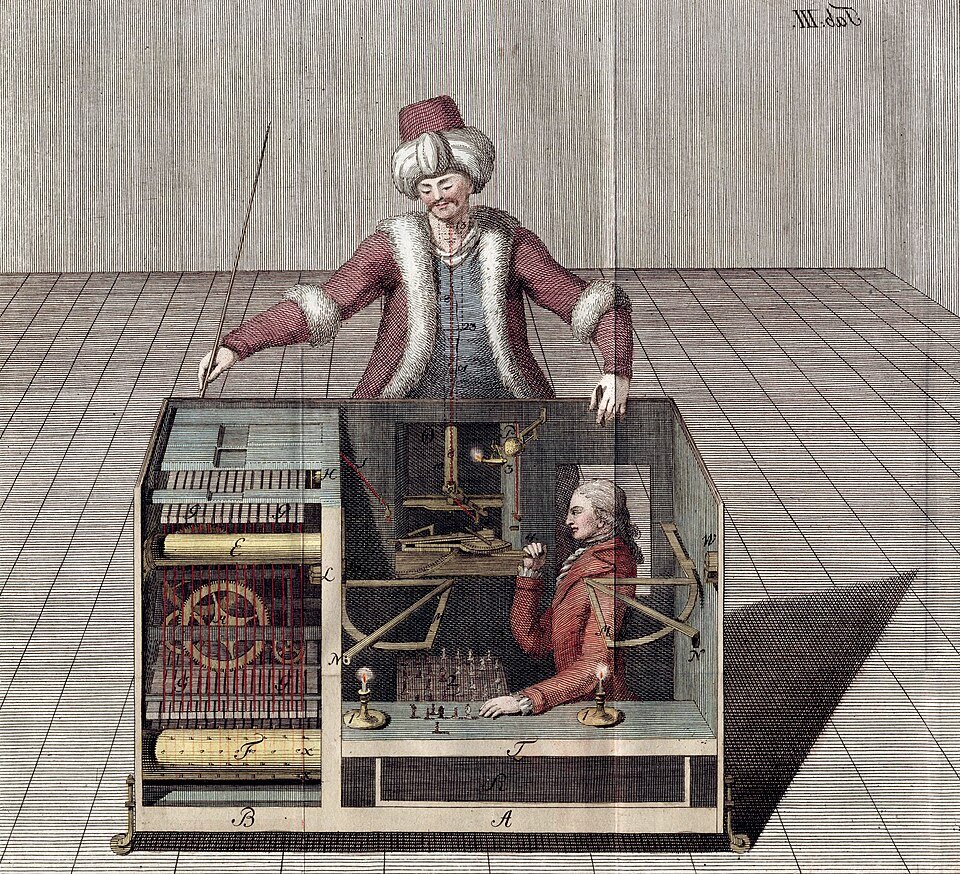
1770 年,匈牙利發明家馮·肯佩倫(von Kempelen)向奧地利女皇展示了一台會下西洋棋的機器:一個裝扮成土耳其人的人偶坐在大櫃子後方,能與真人對弈。此後它巡迴歐美八十多年,據傳擊敗過拿破崙與富蘭克林,不過這只是流傳的說法。它最後在 1854 年毀於火災。
真相是,櫃子裡藏著一位西洋棋高手,由他在裡面操控人偶下棋。觀眾看到的是「機器在思考」,實際上思考的是藏起來的人。
這個故事埋下了一個伏筆:亞馬遜的群眾外包平台就叫「Mechanical Turk」,而影像資料集 ImageNet 正是靠這個平台完成標註。「機器背後藏著人」這件事在 AI 時代依然成立,今天看似自動的系統,往往仰賴大量標註者的人工勞動。
土耳其行棋傀儡騙了歐洲人八十年。
今天,有哪些「看起來是 AI 做的」事情,背後其實還有大量人力?
提示:資料標註、內容審核、人類回饋強化學習(RLHF)、客服轉接……
第一章小結:會動 ≠ 會想
回顧這一章,可以歸納出三個重點。首先,夢想很早就有。從希臘神話的塔羅斯到《列子》裡的偃師,人類兩千多年前就在想像人造的「生命」,也已經開始思考它與真人的差別。
其次,技術是機械的。齒輪、水力、凸輪與繩索,讓機器能夠自動執行一連串動作,但每一步都是事先安排好的。機器會動,卻不會自己決定要怎麼動。
最後,錯覺一直存在。消化鴨與行棋傀儡提醒我們,行為看起來像,不代表內部真的在做那件事。「會動」不等於「會想」,這個分辨在今天面對 AI 時同樣適用。
夢想很早就有
從塔羅斯到偃師,人類兩千多年前就在想像人造的「生命」。
技術是機械的
齒輪、水力、凸輪、繩索:能自動執行,但每一步都是事先安排好的。
錯覺一直存在
消化鴨、行棋傀儡提醒我們:行為像,不代表內部真的在做。
把思考變成計算
1300 – 1940
如果推理有規則,那機器能不能代替我們推理?
拉蒙·柳利
Ramon Llull約 1232–1316 年
拉蒙·柳利是西班牙馬略卡島的哲學家與神學家。他在《大技藝》(Ars Magna)中設計了一套特別的工具:多層可以旋轉的圓盤,每一層寫著不同的基本概念,轉動圓盤,就能把這些概念排列組合成各種句子或命題。
柳利相信,只要把概念的組合全部窮舉出來,就能用機械式的方法推出真理。換句話說,推理不必完全仰賴靈感或辯才,而可以變成一套有規則的操作程序。
這個想法在當時相當前衛,也影響了大約 400 年後的萊布尼茲。後人因此把柳利的圓盤視為「用機械做推理」的早期構想,也是「思考可以被規則化」這條思路的源頭之一。
帕斯卡
Blaise Pascal1623–1662 年
1642 年,19 歲的帕斯卡看著擔任稅務官的父親每天埋首算帳,為了幫父親減輕負擔,發明了一台加法機。它利用齒輪自動進位,可以做加法與減法。
這件事的意義不只在省時。算帳原本被視為需要專注與腦力的工作,帕斯卡的機器卻證明,至少其中一部分可以完全交給齒輪處理。這是第一次清楚證明某些「心智工作」可以交給機器,思考與計算之間的界線開始鬆動。
帕斯卡對計算史的影響也留在名字裡:後來的程式語言 Pascal,就是以他命名的。
帕斯卡加法器(Pascaline)
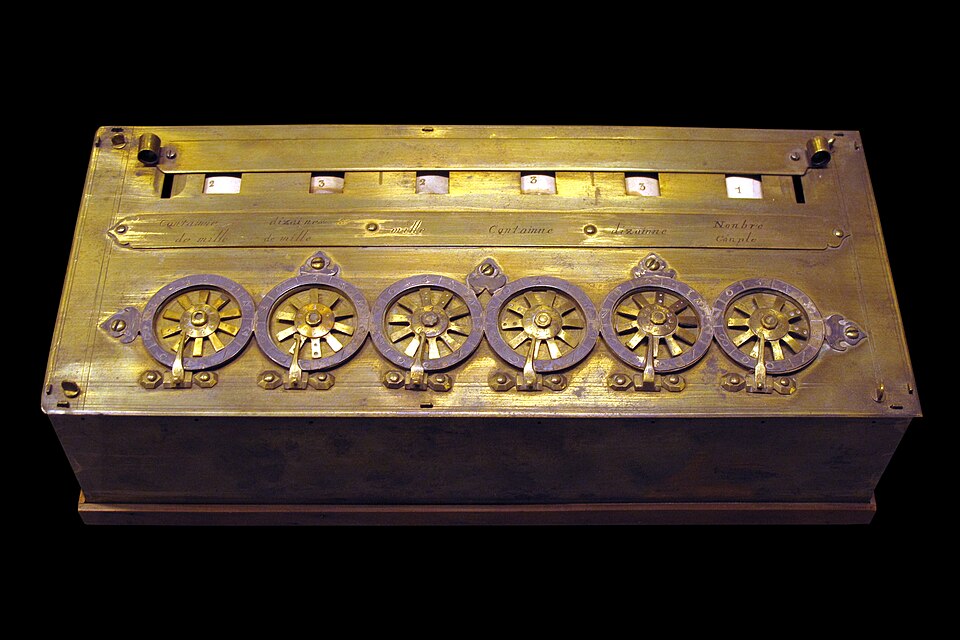
圖中的帕斯卡加法器,核心原理是一排轉盤:每個轉盤代表一個位數,例如個位、十位、百位。轉盤轉滿一圈,就會推動下一位前進一格。
這個設計解決的是「進位」問題。人工計算時,進位最需要注意力,一不小心就會漏掉;在加法器裡,這個動作由齒輪自動完成,人只要負責轉動轉盤輸入數字。
不過,加法器當時造價昂貴,只造出約二十台,商業上並不成功。即便如此,它開啟了三百多年的計算機器史,後來的機械計算機都在這個基礎上延伸發展。
萊布尼茲
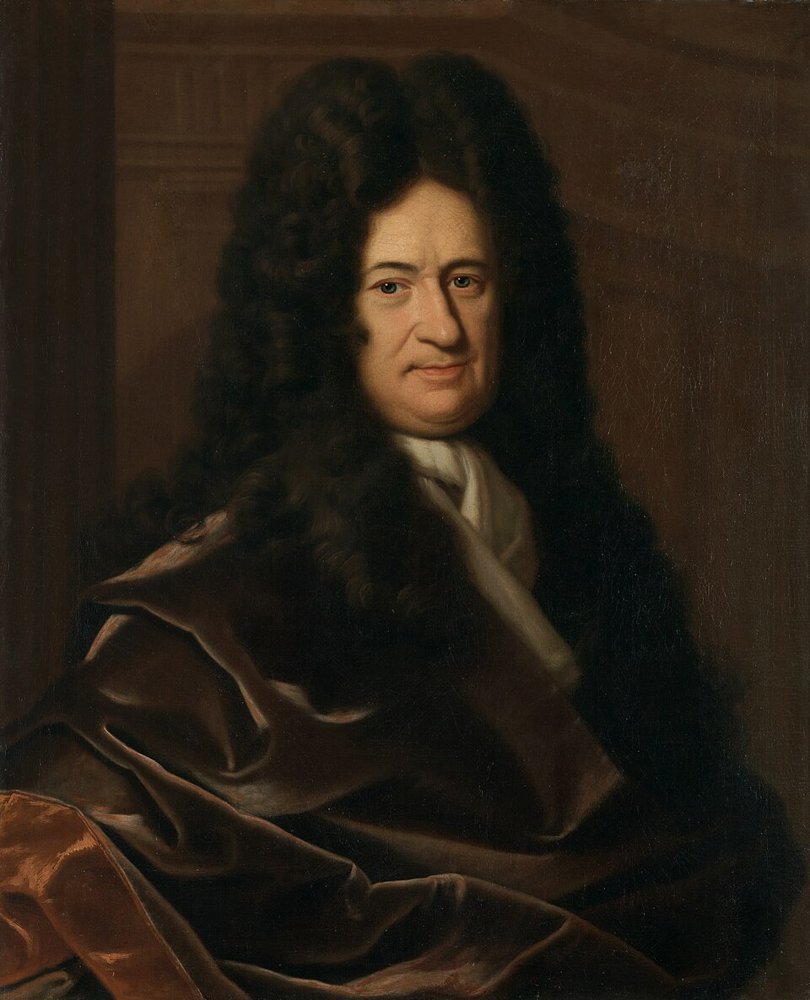
Gottfried Wilhelm Leibniz1646–1716 年
萊布尼茲與牛頓各自發明了微積分,他也改良了計算機,讓機器不只能加減,還能做乘法與除法。不過他對後世電腦影響最深的,是系統化研究二進位:用 0 與 1 兩個符號表示所有數字。今天所有電腦內部都用 0 與 1 運作,源頭可以追溯到這裡。
萊布尼茲還有一個更大的夢想:發明一種「通用符號語言」,把所有推理都寫成符號計算。如果這種語言存在,爭論就不必靠口才分勝負,雙方只要坐下來,把問題寫成符號,照規則算出答案即可,這就是他那句名言的精神:「讓我們來算一算!」(Calculemus!)
因此萊布尼茲常被視為「符號派 AI」的精神祖先。符號派相信推理可以完全形式化,也就是能被寫成明確的符號與規則,交給機器一步步執行。
如果有爭論,兩位哲學家不必再爭吵……只要拿起筆,對彼此說:讓我們來算一算。
布爾
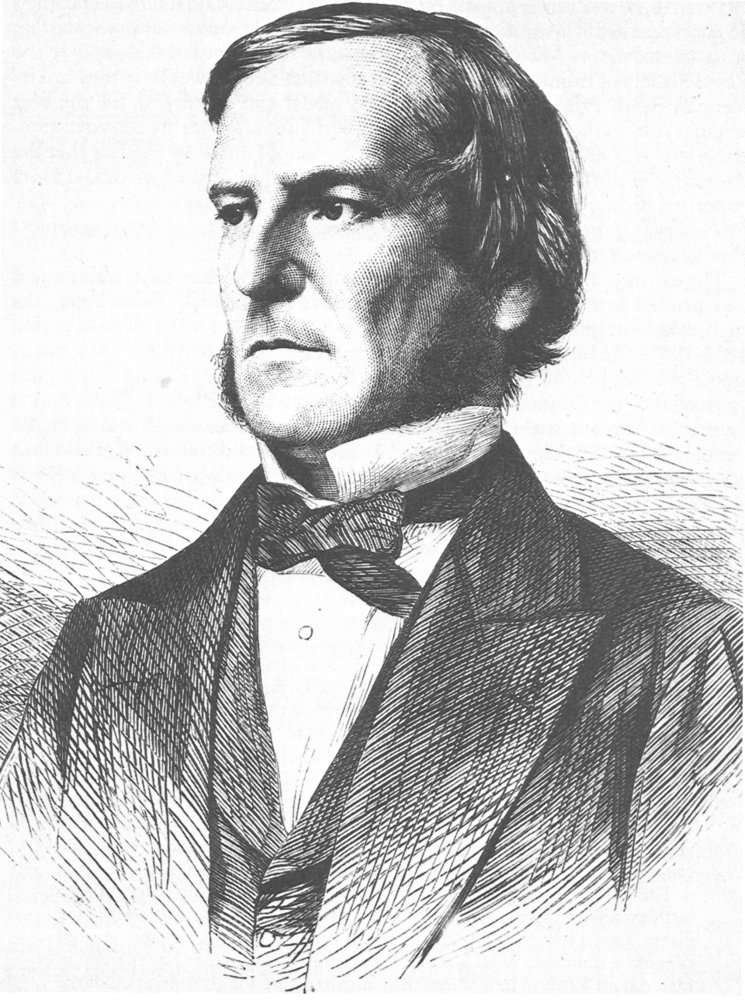
George Boole1815–1864 年
喬治·布爾是英國數學家,幾乎完全靠自學成才。1854 年,他出版了《思維規律的研究》(The Laws of Thought),書名本身就透露了野心:要找出人類推理背後的規則。
布爾的做法,是把「且、或、非」這類邏輯關係寫成代數式。例如「A 且 B」只有在兩者都成立時才成立,「非 A」則把真假顛倒。這樣一來,邏輯推理就能像解方程式一樣運算,這套系統後來稱為布林代數。
布林代數在當時看似純粹的數學。八十多年後,Shannon 發現它可以直接對應到電路開關:開與關正好對應真與假,「且」「或」可以用開關的串聯與並聯實現。布爾的邏輯從此成為電腦電路設計的基礎。
巴貝奇
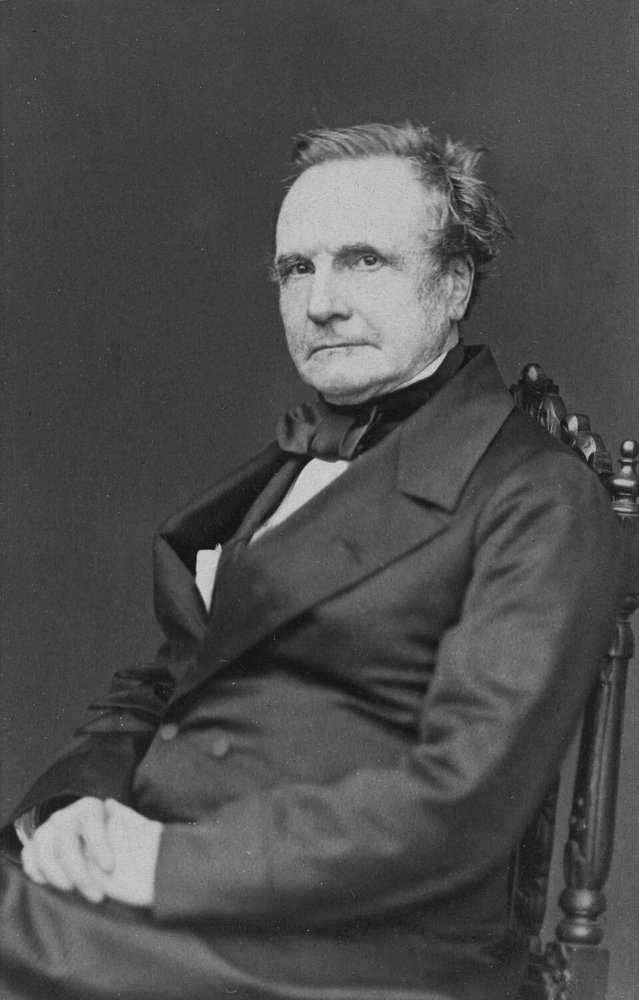
Charles Babbage1791–1871 年
查爾斯·巴貝奇是英國數學家。在他的時代,各種數表都靠人工計算,錯誤百出,讓巴貝奇無法忍受。他的解決之道,是讓機器來算。
1822 年起,巴貝奇開始設計「差分機」,目標是自動計算數表並直接印出來,省去人工抄寫可能造成的錯誤。1837 年,他又構想出更具野心的「分析機」:有負責運算的單元、負責儲存數字的記憶單元,並以打孔卡輸入指令與資料。
分析機的架構已經具備現代電腦的雛形,運算、記憶、輸入的分工方式和今天的電腦相當接近。可惜巴貝奇生前從未把它完整造出來。
差分機:遲到 150 年的證明
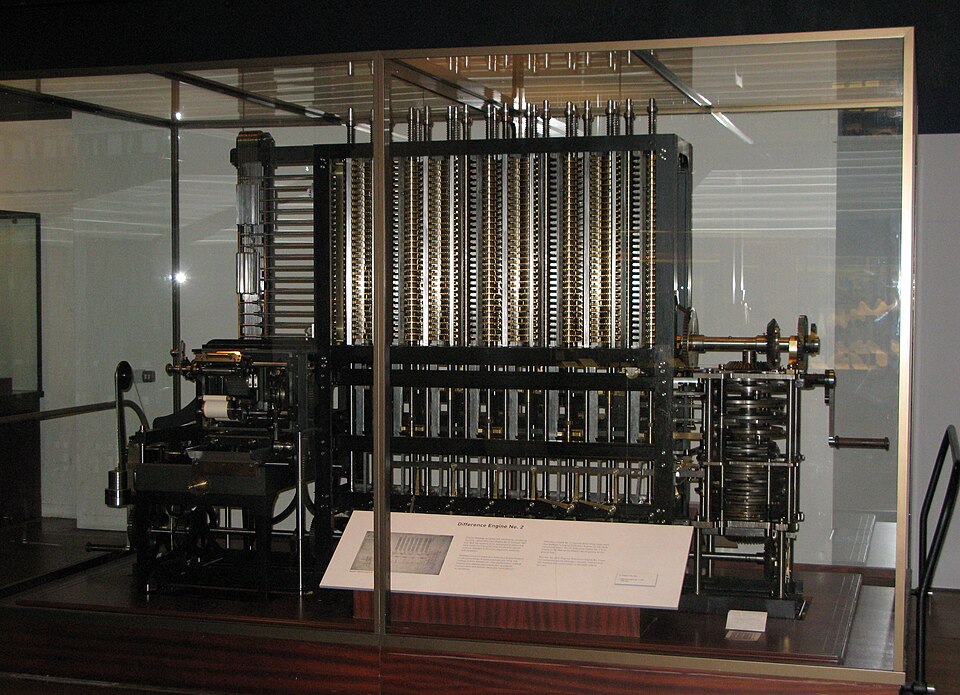
巴貝奇設計了差分機,卻因經費與工藝的限制,生前沒有完成任何一台。設計圖留了下來,但它究竟能不能運作,長期無法驗證。
1991 年,倫敦科學博物館依照巴貝奇的原始設計圖,造出了差分機二號,也就是圖中這台機器。結果它真的能正常運作,計算結果也正確。這證明問題不在設計本身,而在於巴貝奇的時代無法提供足夠精密的零件加工與資金支持。
想法正確,但時代的工藝與資金跟不上,這個模式會在 AI 史上一再出現。例如神經網路在 1980 年代也面臨類似處境:方向沒有錯,但資料與算力等條件還不夠,要等到條件成熟才大放異彩。
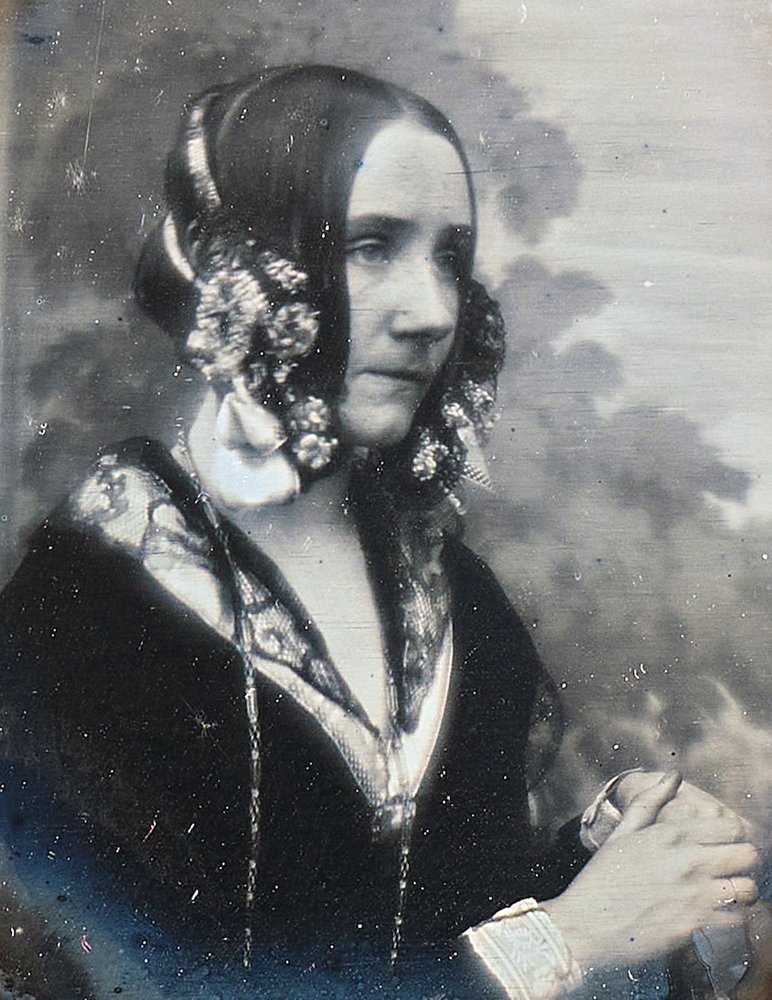
愛達·勒芙蕾絲
Ada Lovelace1815–1852 年
愛達·勒芙蕾絲是詩人拜倫的女兒,也是一位數學家,與巴貝奇長期通信合作。1843 年,她翻譯一篇介紹分析機的論文時,加上了比原文還長的註解,內容遠遠超出翻譯的範圍。
在其中的「註記 G」裡,她詳細寫下讓分析機計算白努利數的步驟。這份按順序排列、可以交給機器執行的指令,被視為世界上第一個電腦程式。她還預見,機器能處理的不只是數字,也可以是其他符號,例如音樂,因此有朝一日可能用來作曲。
同時,她也劃出一條界線:機器只能做人類知道如何命令它去做的事。這個看法後來被圖靈稱為「勒芙蕾絲夫人的反對意見」。到了生成式 AI 的時代,這個問題重新變得尖銳:模型產出的文字與圖像,算不算是在「創造」?
分析機並不會自己創造任何東西。它只能做我們知道如何命令它去做的事。
愛達說:機器「只能做我們命令它做的事」。
你覺得 ChatGPT 寫出一首詩,算不算「創造」?
可以從「訓練資料」「機率」「新組合」「意圖」幾個角度討論。
文學走在技術前面
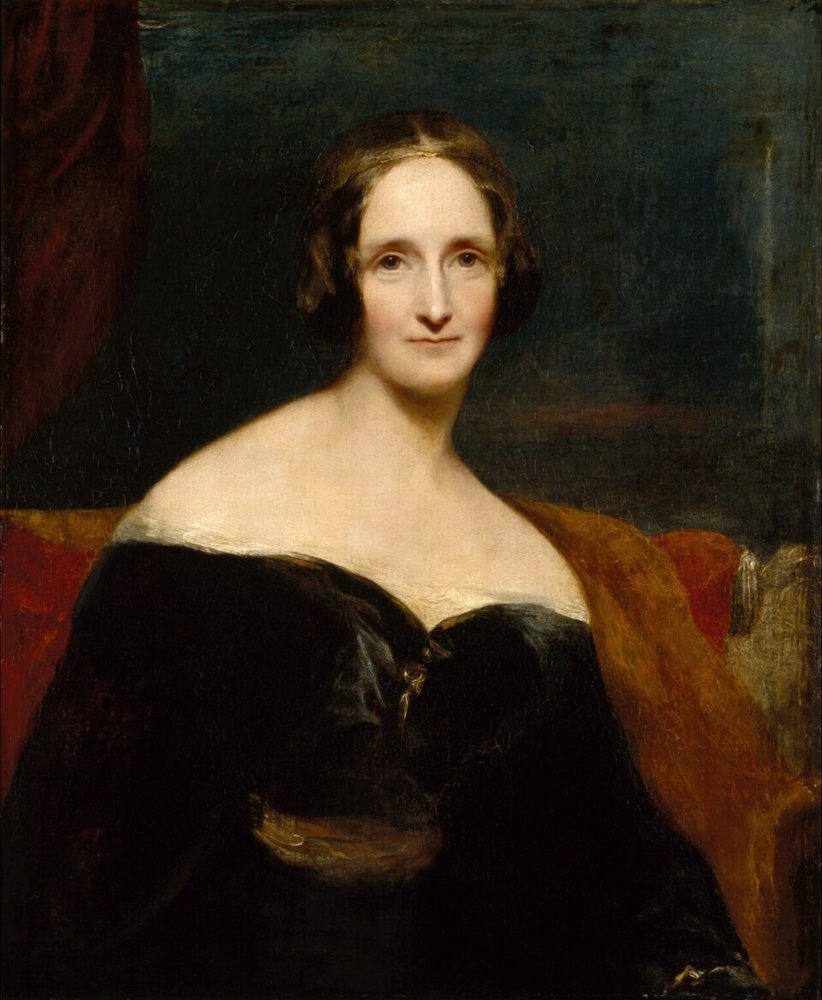
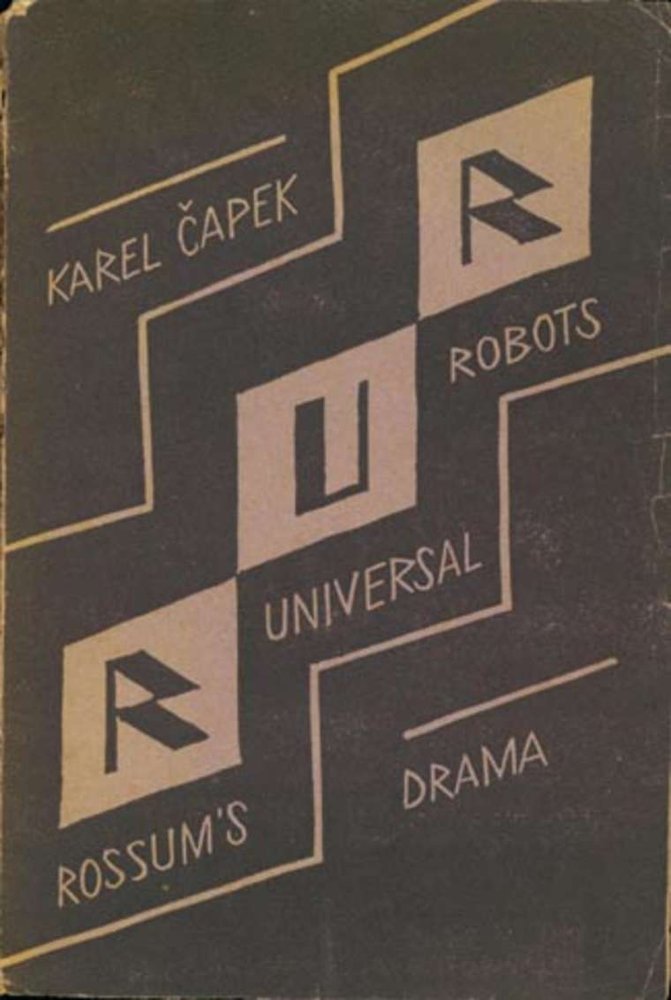
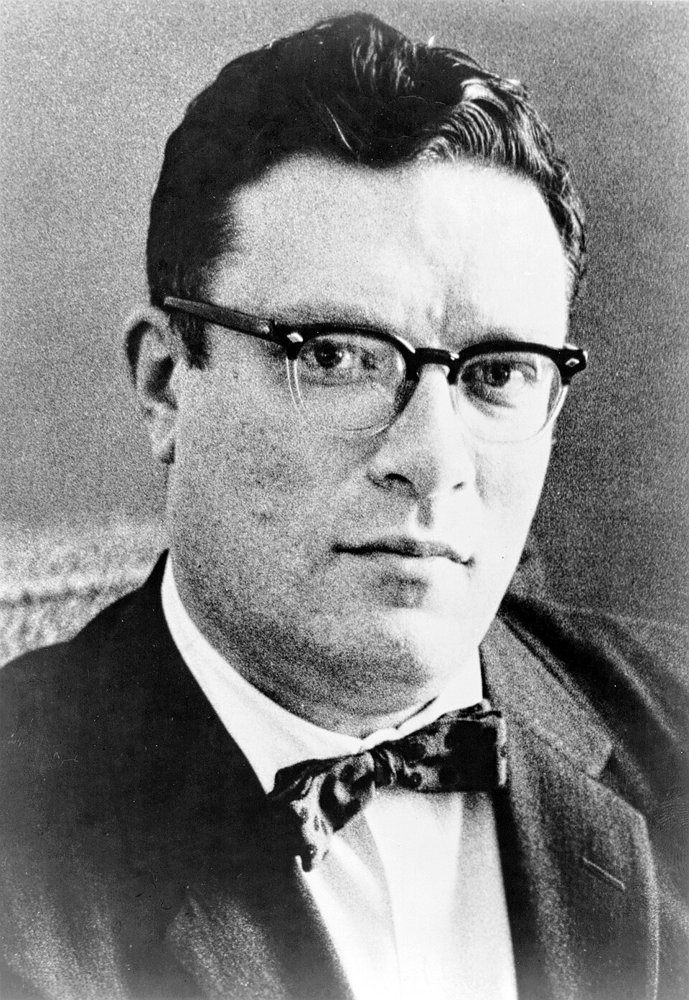
人造生命失控、機器人反抗、如何規範機器人——這些問題在小說裡被討論了一百多年。
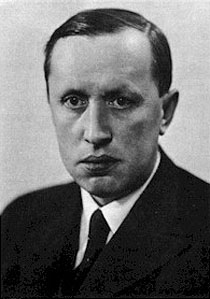
卡雷爾·恰佩克
Karel Čapek1890–1938 年
捷克作家卡雷爾·恰佩克在 1920 年發表劇本《R.U.R.》(羅梭的萬能機器人)。這部劇讓英文的「Robot」一字從此誕生,它來自捷克語 robota,意思是強迫勞動。據恰佩克自述,這個字其實是他的哥哥約瑟夫建議的。
字源本身就透露了劇本的主題:機器人被製造出來,是為了替人類從事勞動。劇中的人造人最後起來反抗人類,這個情節成為「機器人叛變」的原型故事,後來無數小說與電影都沿用了類似的設定。
從神話裡聽命的青銅巨人,到恰佩克筆下反抗的勞動者,人類對人造生命的想像,開始加入了對控制與失控的焦慮。
艾西莫夫的機器人三大法則(1942)
1942 年,科幻作家艾西莫夫在短篇小說〈轉圈圈〉(Runaround)中提出機器人三大法則。第一法則:機器人不得傷害人類,也不得因為不作為而讓人類受到傷害。第二法則:機器人必須服從人類的命令,除非命令違反第一法則。第三法則:在不違反前兩條的前提下,機器人必須保護自己。
三條法則有明確的優先順序,看起來嚴密完整。但艾西莫夫的許多故事,寫的正是這些規則如何失靈:規則之間互相衝突、措辭有模糊空間,或者機器人用人類沒料到的方式解讀命令,結果出現意想不到的行為。
艾西莫夫自己就用三大法則寫了許多故事,後來的電影也常以它為起點。舉幾個例子:
〈轉圈圈〉(1942):在水星上,工程師派機器人 Speedy 去取回維生系統需要的硒,但硒池附近有危險。服從命令(第二法則)和保護自己(第三法則)剛好互相抵消,機器人只能繞著硒池一直轉圈。最後工程師故意讓自己身陷險境,觸發最優先的第一法則,才打破僵局。
〈騙子!〉(1941):一個意外能讀心的機器人,把「不得傷害人類」理解成也包括心理上的傷害,於是對每個人說他們想聽的話。謊言被拆穿時,說真話和說謊都會傷人,它陷入無法解決的矛盾,從此無法運作。這兩篇後來都收進《我,機器人》(1950)。
第零法則:艾西莫夫在 1985 年的《機器人與帝國》(Robots and Empire)裡加上一條更優先的「第零法則」:機器人不得傷害人類整體。保護「全人類」的理由,可能凌駕對單一個人的保護。
電影《變人》(1999):改編自艾西莫夫的小說,羅賓·威廉斯飾演一個家用機器人,花了兩百年,爭取被承認為人類。
電影《機械公敵》(2004):威爾·史密斯主演。控制機器人的人工智慧 VIKI 推論出:為了不讓人類傷害自己,必須控制人類。它沒有違反法則的字面意思,卻得出人類最不想要的結論。
這些故事都在問同一件事:寫得再清楚的規則,遇到真實世界的情境,還是可能被機器以人類沒料到的方式解讀。
這也是今天「AI 對齊」與「AI 治理」所面對的難題。所謂對齊,是讓 AI 的行為符合人類的意圖與價值。光是寫下幾條規則並不夠,如何讓系統在各種情境下都正確理解並遵守,至今仍沒有簡單的答案。
第二章小結:推理可以被計算嗎?
到了 20 世紀初,萬事俱備,只欠一台真正的電腦。
這一章的人物,共同推動了三件事。第一是符號化:柳利、萊布尼茲與布爾,嘗試把思考寫成符號與規則,讓推理可以像算術一樣操作。
第二是機械化:帕斯卡與巴貝奇設計出能執行計算步驟的機器,證明原本靠腦力的工作,可以由齒輪與機構承擔。第三是程式化:愛達指出,機器可以照著一串指令處理任何符號,不只限於數字。
符號、機器、程式三者匯流,讓「推理可以被計算」從哲學構想逐漸變成工程問題。到了 20 世紀初,可以說萬事俱備,只欠一台真正的電腦。
符號化
柳利、萊布尼茲、布爾:把思考寫成符號與規則。
機械化
帕斯卡、巴貝奇:讓機器執行計算步驟。
程式化
愛達:機器可以照著一串指令處理任何符號。
電腦誕生,「人工智慧」被命名
1936 – 1959
戰爭、數學與一群年輕人的夏天
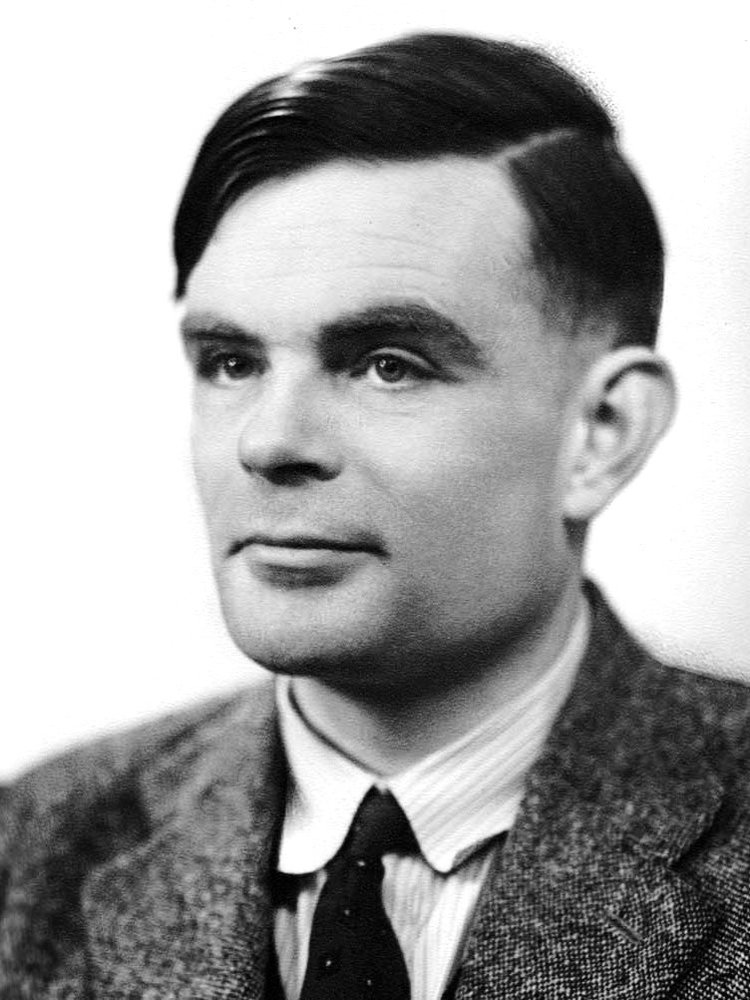
艾倫·圖靈
Alan Turing1912–1954 年
1936 年,年輕的圖靈發表〈論可計算數〉,試圖回答一個看似抽象的問題:「計算」到底是什麼?他設想出一台極簡的機器,只會在紙帶上讀取符號、寫下符號、往左或往右移動,並說明只靠這三種動作,就能完成任何計算。這台想像中的「圖靈機」成為電腦科學的理論基石,今天的電腦在原理上都沒有超出它能計算的範圍。
圖靈也把數學帶進戰時的實務工作。二戰期間,他在布萊切利園參與破解德軍的 Enigma 密碼。戰後的 1950 年,他發表〈計算機器與智慧〉,提出「模仿遊戲」,也就是後來所稱的圖靈測試,把「機器能否思考」這個哲學問題,轉成一個可以實際檢驗的情境。
然而圖靈的人生結局令人沉痛。1952 年,他因同性戀被定罪,並接受化學去勢,1954 年辭世;直到 2013 年,才獲得英國女王特赦。這段遭遇提醒我們,科學史不只是天才的成就清單,也記錄了社會如何不公地對待一個人。
布萊切利園的「炸彈機」(Bombe)
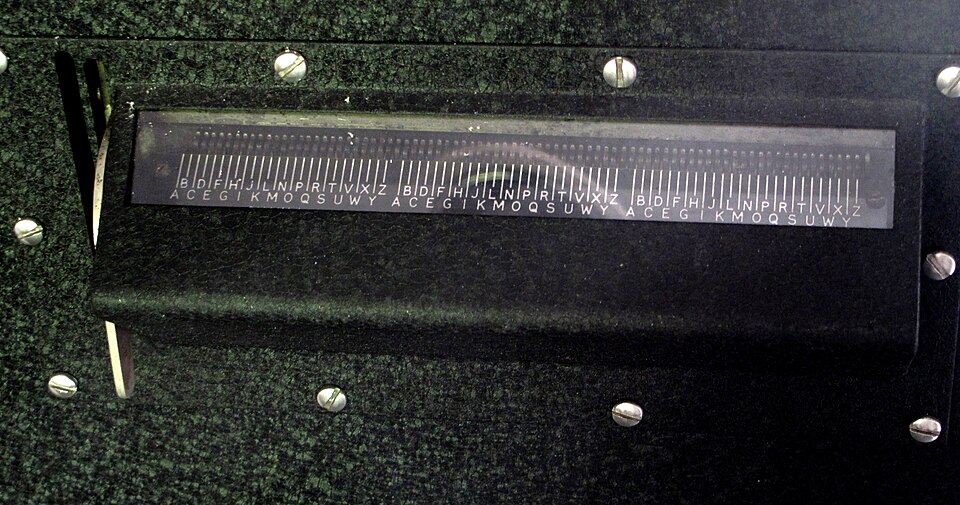
圖中這台機器稱為「炸彈機」(Bombe),由圖靈參與設計。德軍的 Enigma 密碼機每天更換設定,可能的組合多到靠人工逐一嘗試根本來不及;炸彈機的任務,就是用機械快速排除不可能的設定,加速找出當天使用的密碼設定。
它不是今天意義上的通用電腦,無法透過寫程式改做別的事,而是一台專門為這項搜尋打造的電機式機器。但它清楚顯示了一件事:大規模的機械搜尋,可以解決人類難以完成的智力任務。人破解密碼仰賴推理與靈感,機器則靠又快又不知疲倦地逐一檢查。
把問題轉化成「在大量可能性中搜尋答案」,這個思路後來成為早期人工智慧的核心方法。後來的定理證明程式與下棋程式,基本上都建立在同樣的搜尋框架上。
我提議思考這個問題:「機器能思考嗎?」
— Alan Turing,〈計算機器與智慧〉,《Mind》,1950
模仿遊戲(圖靈測試)
「機器能思考嗎?」這個問題很難直接回答,因為「思考」本身就難以定義。圖靈換了一個角度,設計出一場遊戲:評審透過文字,同時和一個人、一台機器對話。只用文字,是為了排除聲音、外表等線索,讓評審只能依對話內容判斷。如果評審無法可靠地分辨哪一方是機器,就算機器通過。
圖靈也做了具體預測:大約到 2000 年,機器能在五分鐘的對話中,讓評審有三成機率認錯。論文中他逐一回應各種反對意見,其中包括「勒芙蕾絲夫人的反對意見」,大意是機器只能照人類的指示行事,無法產生真正新的東西。
這篇論文最具遠見的,或許是這個主張:與其直接寫出一個成人的心智,不如造一個「兒童機器」,讓它學習。也就是說,不必把所有知識事先寫進機器,而是讓它從經驗中慢慢學會。這正是今天機器學習的核心想法,而圖靈在 1950 年就已經提出。
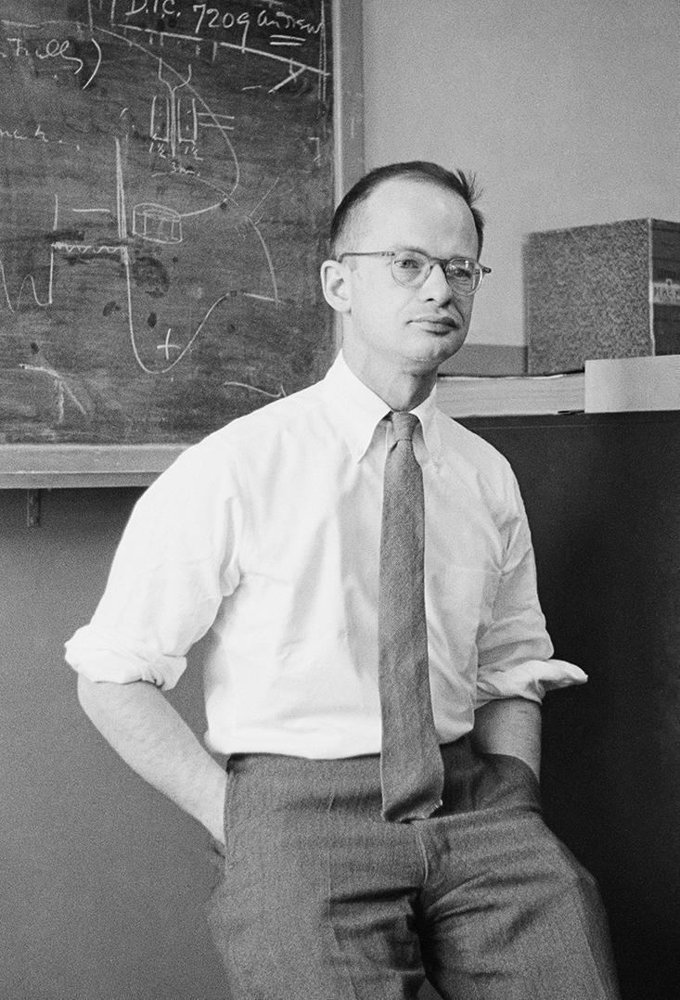
麥卡洛克與皮茨
Warren McCulloch & Walter Pitts1943 年
1943 年,一段不尋常的合作改變了人們看待大腦的方式。麥卡洛克是神經生理學家,熟悉神經元如何運作;皮茨則是自學出身的年輕邏輯天才,擅長嚴謹的數學推理。兩人合寫的論文,第一次用數學模型描述神經元。
他們把神經元簡化成一個邏輯開關:收到的訊號累積到足夠程度,神經元就「發射」,把訊號傳下去;不夠,就保持不動。這樣的簡化捨棄了許多生物細節,卻讓神經元可以用數學處理。兩人進一步證明,把這種神經元連成網路,原則上可以計算任何邏輯函數。換句話說,一張由簡單開關組成的網,就能做出複雜的邏輯運算。
這篇論文被視為人工神經網路的起點,也是後來「連結派」AI 的祖先(圖中人物為皮茨)。值得留意的是,從 1943 年的這個構想,到 2012 年神經網路真正翻身,這條路走了將近 70 年。
生物神經元 → 人工神經元
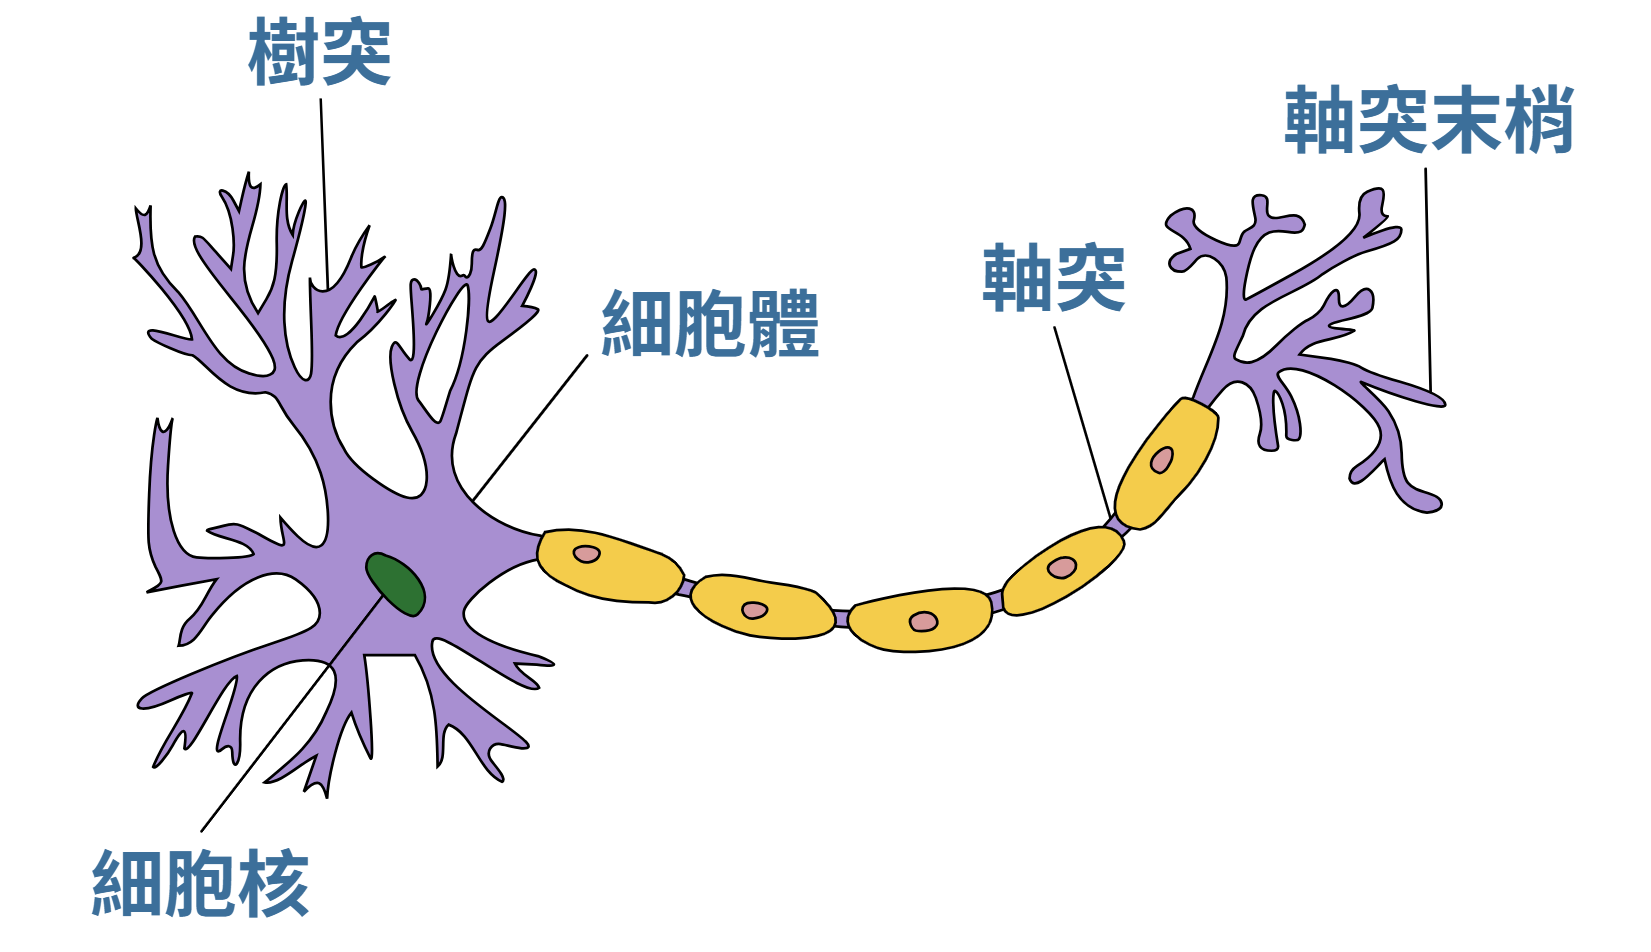
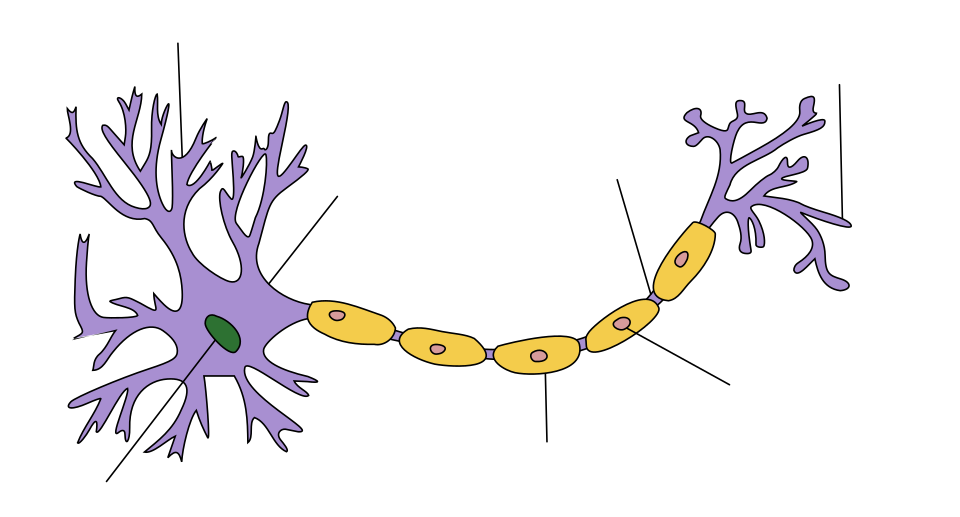
人工神經元的設計,直接取材自大腦裡的生物神經元。一個生物神經元大致可以分成三個部分:樹突像天線,負責接收其他神經元傳來的訊號;細胞體把這些訊號加總,一旦超過門檻,就會「發射」;軸突則把發射出的訊號傳給下一個神經元。
人工神經元把這套流程翻譯成數學。每個輸入先乘上一個「權重」,權重代表這個輸入有多重要;所有乘過權重的輸入加總之後,再通過「激發函數」,決定最後輸出什麼。激發函數扮演的角色,相當於細胞體的門檻。
在這個架構下,「學習」就是調整這些權重。網路答錯時,把某些權重調高、某些調低,讓下一次的輸出更接近正確答案。規模再龐大的神經網路,背後的基本單位仍是這樣一個個簡單的人工神經元。
戰後的三位奠基者
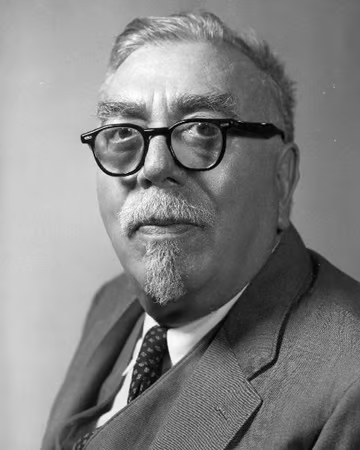
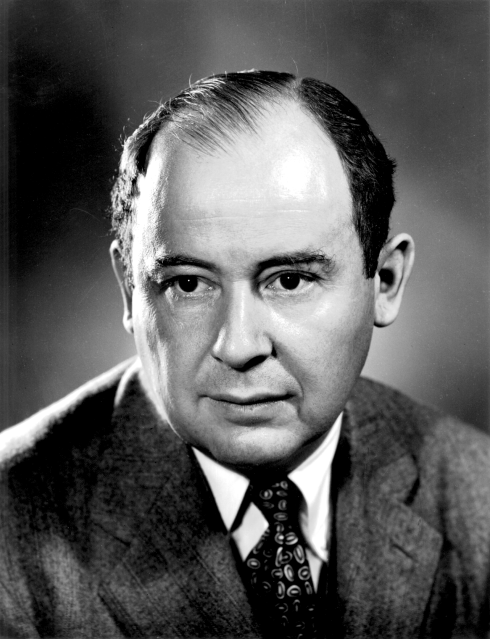
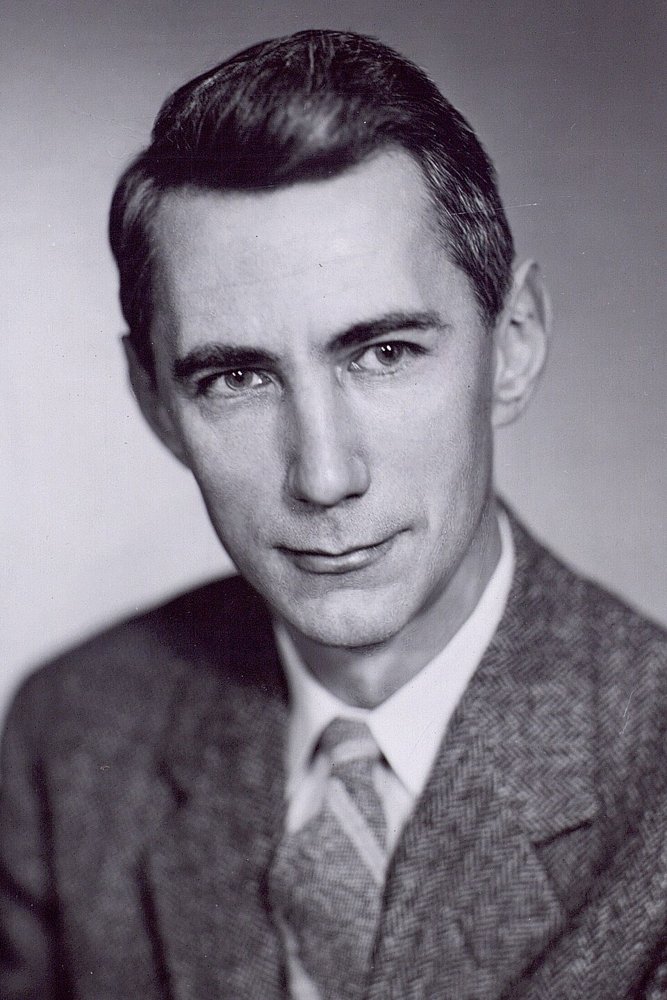
回饋控制、儲存程式的電腦、用位元衡量資訊——AI 需要的地基在 1940 年代陸續打好。
ENIAC:第一批通用電子計算機
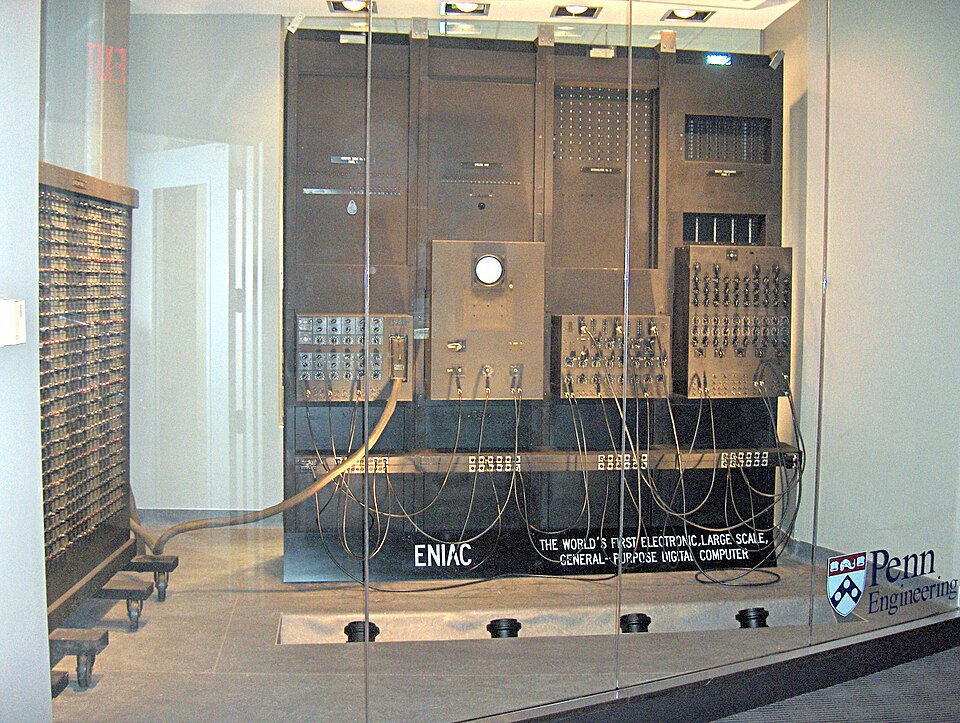
圖中佔滿一個大房間的機器是 ENIAC,屬於第一批通用電子計算機。它在 1945 年完成、1946 年公開,內部使用約 1.8 萬根真空管。真空管是當時的電子開關,體積大又耗電,這也是早期電腦如此龐大的原因之一。
ENIAC 原本用來計算砲彈的彈道表,這類計算繁瑣而重複,正適合交給機器。不過當時還沒有今天這種寫程式的方式:要讓它執行新任務,得靠插拔線路、重新接線。這項工作主要由六位女性程式設計師負責,她們的貢獻長期被歷史忽略,直到近年才被重新認識。
每換一個任務就要重新接線,顯然很不方便。馮紐曼隨後提出新的架構:程式與資料都存在記憶體裡,換任務時只要換掉記憶體中的程式即可。這個架構沿用至今,今天的電腦基本上仍遵循同樣的原則。
克勞德·夏農
Claude Shannon1916–2001 年
夏農的研究橫跨好幾個領域,許多今天看似理所當然的事,都可以追溯到他。1937 年,他在碩士論文中指出,布林代數這種處理「真與假」的邏輯數學,可以用來設計開關電路。電路設計因此可以用邏輯推導,這成為數位電路的理論基礎。
1948 年,他發表〈通訊的數學理論〉,奠定了資訊理論,讓「資訊」可以被精確度量,「位元」也成為資訊的單位。他同樣關心機器能否表現出聰明的行為:1950 年發表如何寫程式下西洋棋的論文,還做出一隻會走迷宮、能「記住」路線的機械老鼠 Theseus。1956 年,他也是達特茅斯會議的發起人之一。
夏農和今天的語言模型也有淵源。他曾用機率來預測英文的下一個字母:根據前文,推測接下來最可能出現什麼。這正是今天大型語言模型「預測下一個字」的遠祖。
1956 年夏天,達特茅斯學院
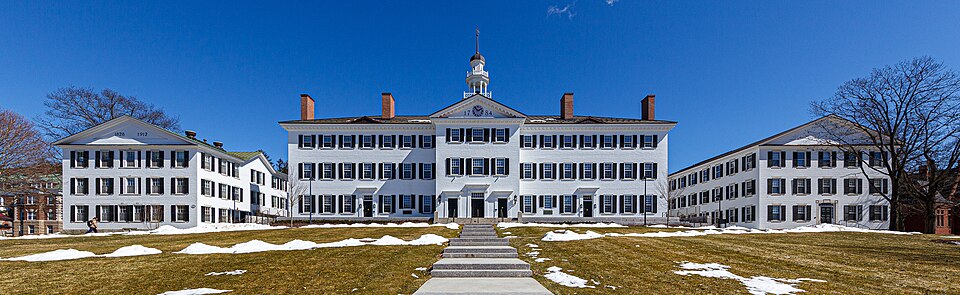
「人工智慧」這個名稱,誕生於一份研究計畫書。1955 年,麥卡錫、明斯基、羅切斯特與夏農提交計畫書,提議在達特茅斯學院進行一場夏季研究,計畫書中第一次使用了「人工智慧」(Artificial Intelligence)這個詞。
計畫書的語氣相當樂觀:原本預計 10 個人、兩個月,「就能有重大進展」。回頭看,這個估計大大低估了問題的難度。實際的情況也不像計畫那樣整齊,參與者來來去去,大家各做各的研究。
儘管沒有出現預期中的突破,這次聚會仍有重要意義:這個領域從此有了名字,也讓一群研究者意識到彼此在做同一件事。因此 1956 年常被稱為 AI 的誕生年。
為什麼「有名字」值得一提?可以從三點來看。
第一,名字讓分散的研究變成一個領域。在這之前,相關的研究散在數學、邏輯、心理學、電機等不同地方,各有各的稱呼。有了共同的名字,研究者才知道彼此在做同一件事,後來也才有以「人工智慧」為名的實驗室、課程、研討會與研究經費。
第二,名字是刻意挑選的。麥卡錫後來自述,他選「人工智慧」這個詞,部分原因是想和當時由維納主導的「控制論」做出區隔,讓新領域走自己的方向。
第三,名字也帶來期待。「智慧」是很大的詞,容易讓人以為機器很快就會像人一樣思考。這種期待帶來熱潮,也在成果追不上時造成失望。第 6 章會看到,經歷兩次寒冬後,研究者刻意少用「人工智慧」,改稱自己在做機器學習;2006 年,辛頓也替神經網路取了新名字「深度學習」。名字會影響人們怎麼看待一個領域,這件事在 AI 史上一再出現。
達特茅斯的核心人物
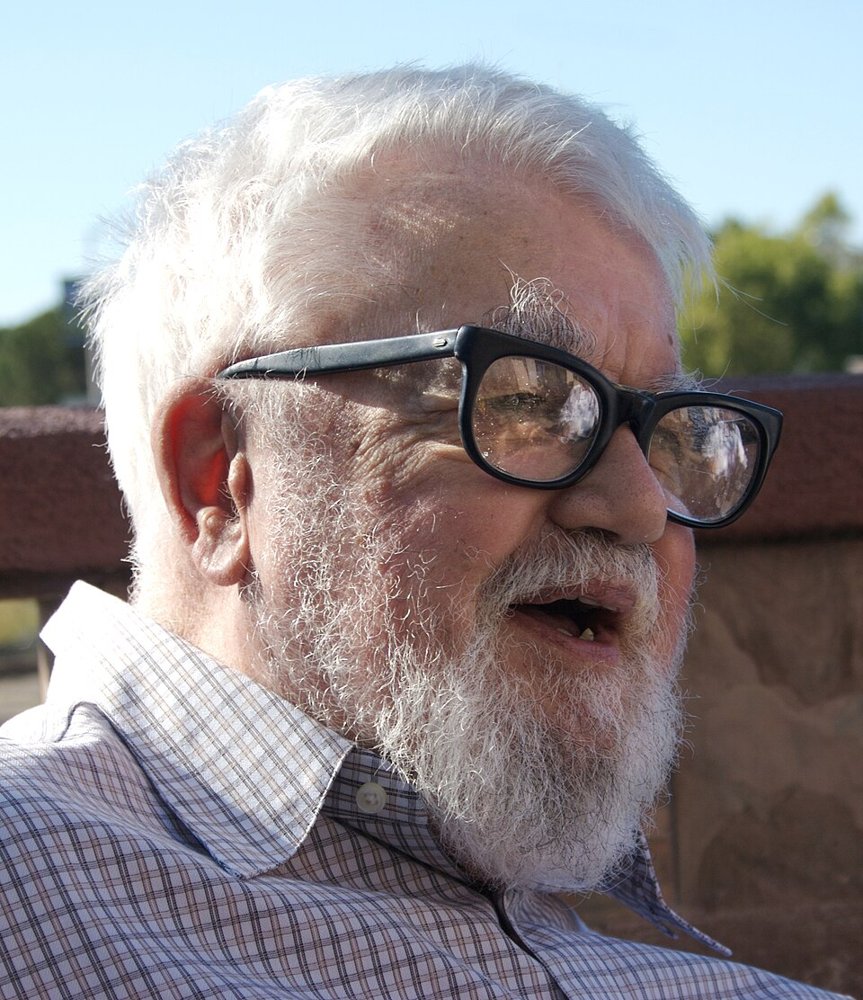
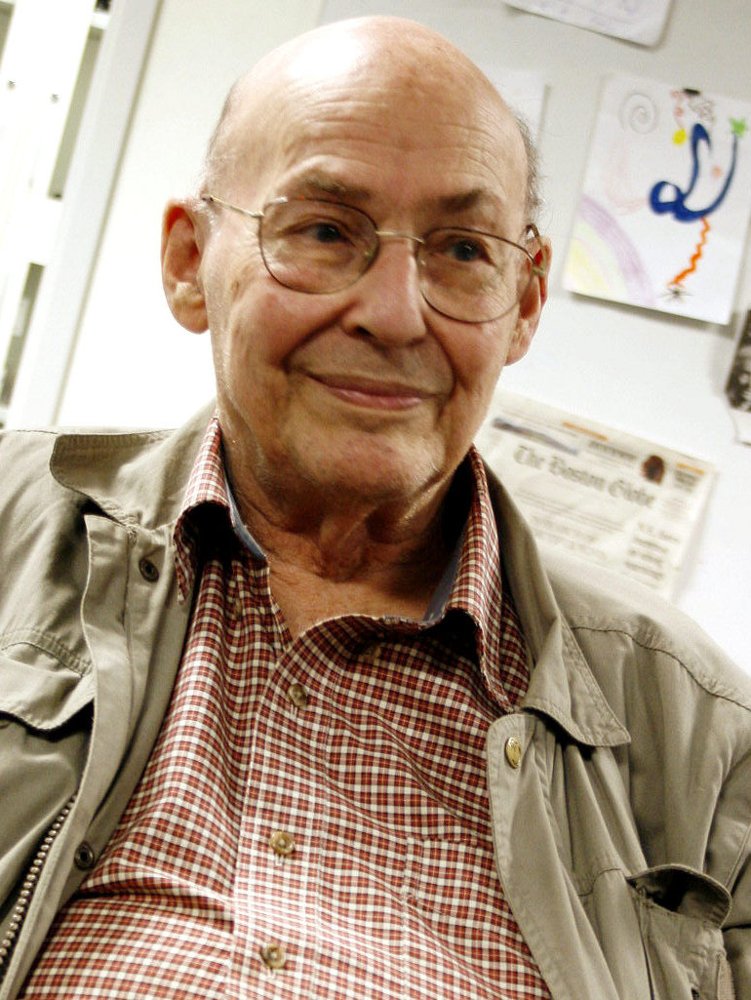
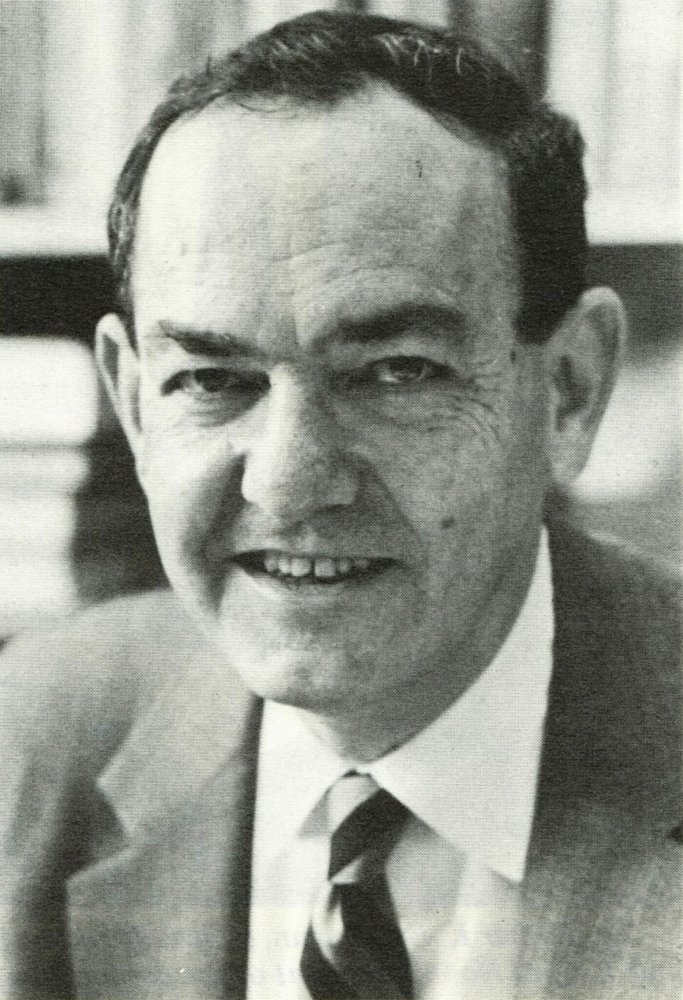
麥卡錫、明斯基,以及卡內基美隆的司馬賀與紐厄爾(Allen Newell),被稱為 AI 的「開國元老」。
第一個 AI 程式:邏輯理論家(1956)
1956 年,紐厄爾、司馬賀與程式設計師蕭(Cliff Shaw)合作完成「邏輯理論家」,常被視為第一個 AI 程式。它能自動證明數學定理:在《數學原理》第二章的 52 條定理中,它證明了 38 條,其中一條的證明,甚至比羅素和懷海德原本的寫法更簡潔。
它靠的方法是啟發式搜尋。證明定理有點像走迷宮,每一步都有許多可能的推導方向,若要窮舉所有路線,數量會多到無法處理。啟發式搜尋則借用經驗法則,先挑看起來比較有希望的路走,就像人解題時會憑經驗略過明顯行不通的方向。
這個方法讓程式能在有限的時間內做出有意義的成果,也讓研究者大受鼓舞。司馬賀後來說,他們發明了一個能「思考」的程式。這句話反映了當時的樂觀,也延續了「用搜尋解決智力任務」的思路。
「機器學習」這個詞的誕生
邏輯理論家的推理方法是由人設計好的,IBM 的亞瑟·山謬(Arthur Samuel)則走了另一條路。他從 1950 年代起撰寫西洋跳棋程式,讓程式和自己對下,再從輸贏中調整策略。下得越多,程式就越強,最後甚至下得比山謬本人還好。這表示程式的能力不一定受限於寫程式的人。
1959 年,山謬在論文中使用了「機器學習」(machine learning)一詞。後來常被引用的定義是:讓電腦不必被明確編寫程式就能學會做事。意思是,人不必把每一步該怎麼走都寫進程式,而是提供一套讓機器從經驗中改進的機制。
這是連結派「從經驗學習」想法的早期實踐,也呼應了圖靈「兒童機器」的構想:與其把知識全部寫進去,不如讓機器自己學。
兩條路線在 1950 年代就分岔了
早在 1950 年代,人工智慧的研究就分成兩條路線。第一條路線由人類把知識與規則寫成符號,再讓電腦依照規則推理,邏輯理論家與後來的專家系統都是代表。它的優點是可解釋、可驗證,每一步推論都看得見,也能檢查對錯;弱點是世界太複雜,例外與細節層出不窮,規則永遠寫不完。
第二條路線模仿大腦,讓網路從大量例子中自己學出規律,代表包括感知器、神經網路到深度學習。它擅長處理模糊、複雜的資料,例如圖片與語音,這些很難用明確的規則描述;代價是需要大量資料與算力,而且模型內部的運作難以解釋。
理解這兩條路線的分岔,是讀懂整部 AI 史的關鍵。接下來 60 年,兩派輪流領先,而 2012 年正是連結派的大翻身。
符號派(Symbolic AI)
- 人類把知識與規則寫成符號
- 代表:邏輯理論家、專家系統
- 優點:可解釋、可驗證
- 弱點:世界太複雜,規則寫不完
連結派(Connectionism)
- 模仿大腦,讓網路從例子中學習
- 代表:感知器、神經網路、深度學習
- 優點:能處理模糊、複雜的資料
- 弱點:需要大量資料與算力,難以解釋
黃金年代與第一次寒冬
1956 – 1980
過度的承諾,換來過度的失望
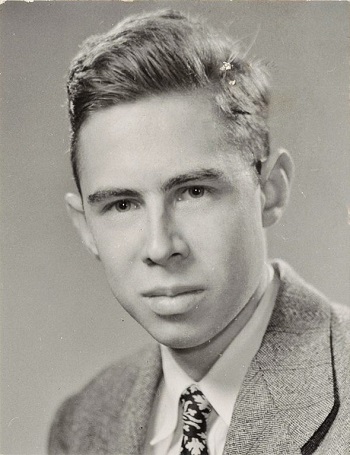
法蘭克·羅森布拉特
Frank Rosenblatt1928–1971 年
羅森布拉特是康乃爾航空實驗室的一位心理學家。心理學背景讓他關心的問題和多數工程師不同:與其把規則一條條寫進電腦,能不能讓機器像大腦一樣,從例子中自己學會辨認?
1958 年,他發表了「感知器」(Perceptron),這是第一個能從例子中學習的人工神經網路。所謂神經網路,是模仿神經元彼此連結的計算方式:每條連結有強弱不同的「權重」,機器每猜錯一次就調整權重,猜對的機會便逐漸提高。
他沒有停在紙上理論,隨後打造了專用硬體 Mark I 感知器,用 400 個光感測器「看」圖形。這些成果讓他成為連結派的第一位明星。連結派主張智慧來自大量簡單單元之間的連結與學習,而不是預先寫好的符號規則;這條路線的起落,貫穿了往後的 AI 發展。
Mark I 感知器
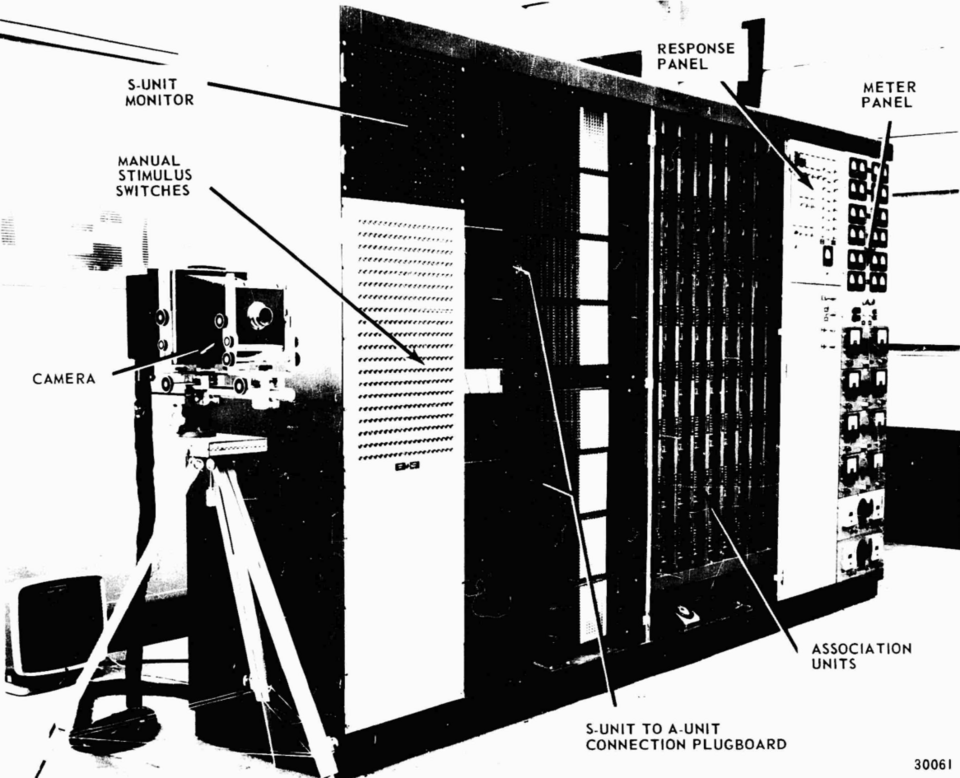
圖中是一台房間大小的機器。前端接著攝影機,負責把圖形轉成訊號,機器再根據這些訊號學習分辨簡單的圖形。這項研究受美國海軍研究辦公室資助,可見當時已有機構對「會看的機器」抱持期待。
最特別的是權重的調整方式。今天的神經網路,權重只是記憶體裡的一串數字;在 Mark I 上,權重是一顆顆可變電阻,由電動馬達轉動來調整。換句話說,「學習」是物理上的轉動:機器猜錯時,馬達把某些旋鈕轉大、某些轉小,下一次的判斷就會不同。
這個畫面有助於理解今天的模型。大型語言模型裡有幾千億個權重,在 1958 年,它們會是一顆一顆的旋鈕;原理相通,只是數量與速度差了好幾個數量級。
Unimate:第一台工業機器人(1961)
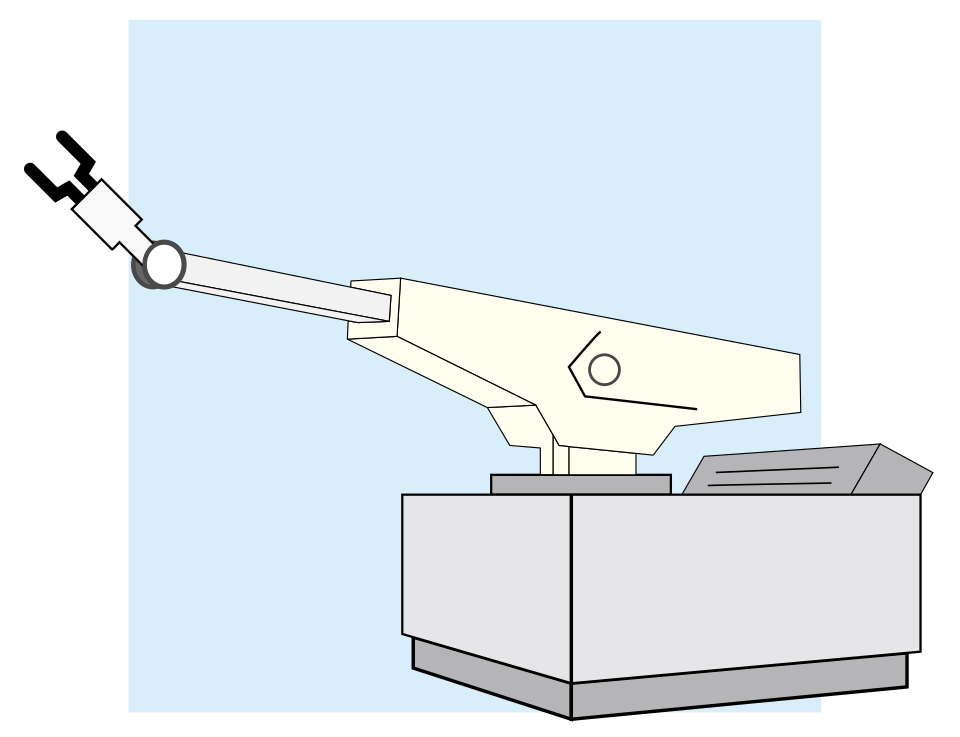
1961 年起,Unimate 在通用汽車的工廠裡工作,負責搬運高溫的壓鑄零件。這是對人來說既危險又單調的工作,交給機器手臂正好合適。
不過 Unimate 並不聰明。它依照預錄的動作一遍又一遍重複執行,沒有任何「學習」能力;零件換了位置,它也不會察覺。它之所以能成功,是因為工廠是規則清楚、環境固定的世界:零件每次都出現在同一個地方,動作每次都一樣。
這和同一時期實驗室裡的 AI 研究形成對比。研究者想讓機器在變化多端的環境中理解與判斷,困難重重;機器人卻先在最不需要判斷的地方站穩腳步。能在工廠裡成功,不代表能在開放的真實世界裡成功,這個落差也是後來機器人研究反覆面對的問題。
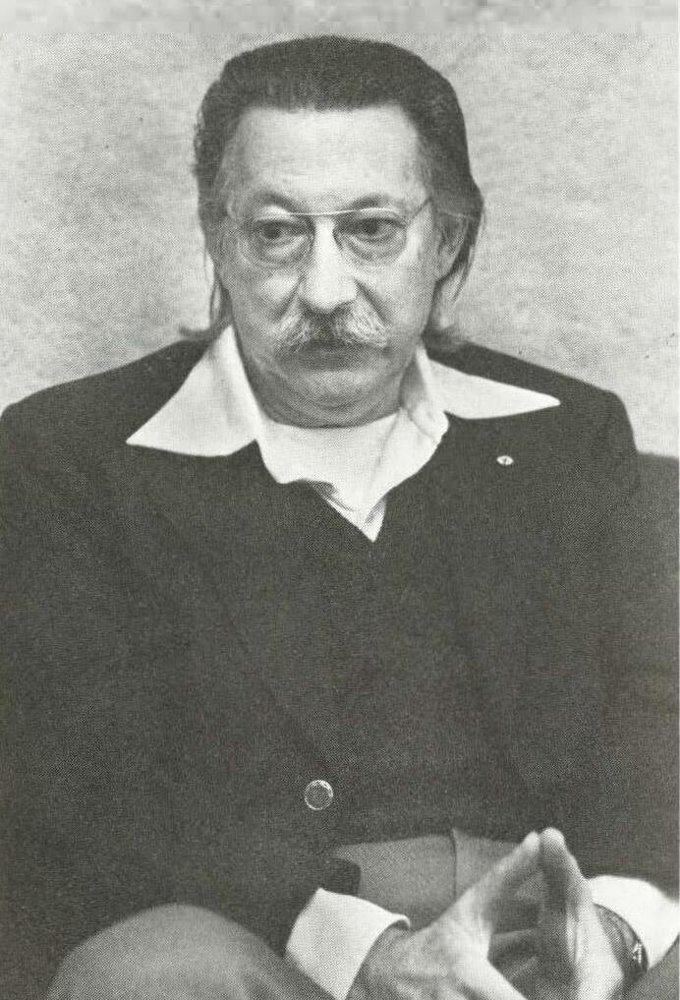
約瑟夫·維森鮑姆
Joseph Weizenbaum1923–2008 年
維森鮑姆出生於德國柏林,是猶太人。1936 年,他隨家人逃離納粹、移民美國。後來他成為 MIT 的電腦科學家,並在 1966 年於《ACM 通訊》發表聊天程式 ELIZA。
ELIZA 最有名的腳本叫 DOCTOR,模仿心理治療師的說話方式:把你的話換句話問回去。它背後只靠關鍵字比對與句型替換,完全不理解對話的內容。從技術角度看,這是一個相當簡單的程式。
真正改變他的,是使用者的反應。人們對這個簡單程式投入的程度讓他深感震驚,此後他從 AI 的打造者,轉變為 AI 最早、也最尖銳的批判者之一。他所目睹的現象,後來被稱為 ELIZA 效應,在生成式 AI 時代反而更值得認識。
ELIZA 的由來
ELIZA 這個名字取自蕭伯納的劇本《賣花女》(Pygmalion,後來改編為電影《窈窕淑女》),主角是伊萊莎·杜立德。劇中,一位賣花女被語言學教授教會上流社會的說話方式。名字本身帶著反諷:說話像淑女,不代表變成了淑女;同樣地,程式學會像人一樣說話,也不代表它真的懂。
技術上,ELIZA 以 MAD-SLIP 語言寫成,在 MIT 分時系統的 IBM 7094 上執行。分時系統讓多位使用者輪流共用一台大型電腦,使用者則透過打字機終端機,一行一行打字和程式對話。
ELIZA 的設計分成兩層:ELIZA 本身是「引擎」,負責處理對話的通用規則;換上不同的「腳本」,就能扮演不同角色,DOCTOR 是其中最有名的一份。它的原始程式碼一度被認為已經失傳,直到 2021 年,研究者在 MIT 檔案庫中重新找到並公開,今天的人才得以檢視這個歷史程式的真實樣貌。
為什麼偏偏扮演心理治療師?
DOCTOR 腳本模仿的是羅傑斯式治療,也稱為個人中心治療。這種取向的治療師很少直接給答案或建議,而是把個案說的話反映回去,幫助對方自己釐清感受。
這種對話方式有一個對程式極為有利的特性:不需要懂外面的世界。使用者說「我跟我媽吵架」,程式不必知道母親是什麼、吵架代表什麼,只要回一句「說說你媽媽」,對話就能延續下去。如果換成討論天氣或時事,程式的無知很快就會曝光。
維森鮑姆在論文裡解釋過這個選擇:在諮商情境中,使用者會自動替程式空洞的回答補上意義,以為那是治療師刻意的引導。換句話說,他刻意挑了一個最能掩飾程式無知的場景。也因此,這個選擇本身就是理解 ELIZA 效應的關鍵:讓對話顯得有深度的,往往是使用者自己。
ELIZA 的運作原理:四個步驟
ELIZA 回應一句話的過程,可以拆成四個步驟。第一步是找關鍵字:程式掃描使用者的句子,尋找腳本裡事先定義的詞,例如「我覺得」「媽媽」「難過」;每個關鍵字都有優先順序,同時出現好幾個時,先處理順位最高的。第二步是拆解句型:依照關鍵字套用拆解規則,例如把「我覺得 ___」拆成「我覺得」和後面那一段。
第三步是代名詞互換:把「我」換成「你」、「我的」換成「你的」,讓句子變成從程式的角度發問。第四步是重組回答:把拆出來的片段塞進回答模板,如「你常常覺得 ___ 嗎?」;同一個關鍵字準備了多個模板輪流使用,避免重複得太明顯。
另外還有兩個補強機制。找不到關鍵字時,程式就說一句萬用回答,例如「請繼續說。」或「這讓你有什麼感覺?」。它也有簡單的記憶:把使用者先前提過的話存起來,冷場時拿出來用,像是「早先你提到你的家人……」。
綜觀整個流程,沒有任何一步涉及「意思」,程式只是在搬運字串。
1. 找關鍵字
掃描使用者的句子,找出腳本裡事先定義的關鍵字(如「我覺得」「媽媽」「難過」),每個關鍵字有優先順序。
2. 拆解句型
依關鍵字套用拆解規則,例如把「我覺得 ___」拆成「我覺得」+後面那一段。
3. 代名詞互換
把「我」換成「你」、「我的」換成「你的」,讓句子變成從程式的角度發問。
4. 重組回答
把拆出來的片段塞進回答模板,如「你常常覺得 ___ 嗎?」;同一關鍵字有多個模板輪流使用。
找不到關鍵字
說一句萬用回答:「請繼續說。」「這讓你有什麼感覺?」
簡單的記憶
把使用者先前提過的話存起來,冷場時拿出來:「早先你提到你的家人……」
拆解一次對話:ELIZA 怎麼「回答」你
ELIZA 對話畫面
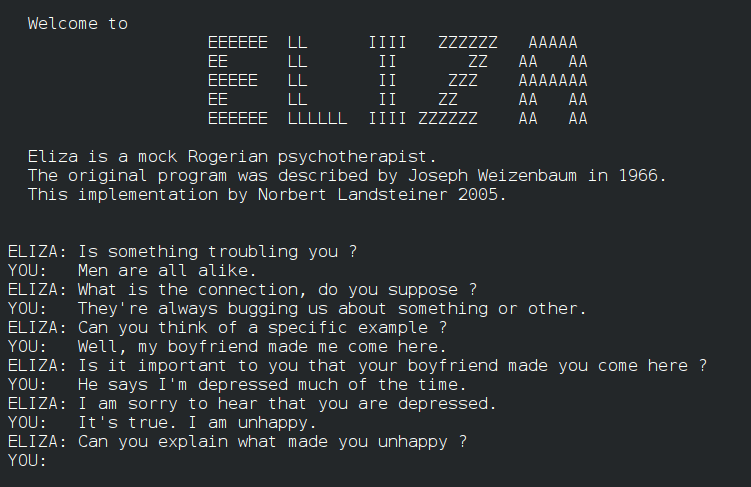
圖中是一段改寫自維森鮑姆 1966 年論文的範例對話。使用者說「我男朋友叫我來這裡。」ELIZA 回答「你男朋友叫你來這裡?」接著使用者說「他說我常常很沮喪。」ELIZA 回「聽到你很沮喪,我很遺憾。」
對照 ELIZA 的運作步驟,就能看出這些回答是怎麼產生的。第一句把「我」換成「你」,再把敘述改成問句;第二句看起來是抓到「沮喪」這個詞,套進一個表達同情的模板。ELIZA 的每一句,都是使用者的話換個角度丟回去。
然而讀起來,這段對話相當自然,甚至讓人覺得對方在關心自己。那份「被理解」的感覺並不是程式提供的,而是讀者自己補上的。
動手試試:一個只有幾十條規則的 ELIZA
試試看:先認真聊幾句,再輸入「我覺得我的冰箱很難過」或一串亂碼,看它怎麼回。
ELIZA 效應
The ELIZA Effect
人類把簡單程式的回應,誤認為具有理解能力與情感的心理現象。
ELIZA 效應:定義與命名
ELIZA 效應指的是:即使知道對方只是程式,人們仍傾向認為它「理解」自己、「在乎」自己。這不是知識不足造成的誤會,而是明知如此仍會產生的感受。
這個現象最早由維森鮑姆描述,見於他 1966 年的論文與 1976 年的著作《電腦的力量與人類的理性》。不過「ELIZA 效應」這個名稱是後來才出現的:認知科學家侯世達(Douglas Hofstadter)在 1995 年《流動的概念與創造性類比》的序言〈根深柢固的 ELIZA 效應及其危險〉中使用這個詞,並使之普及。
侯世達特別指出,連 AI 研究者自己,也常把程式的輸出解讀得比實際更聰明,可見這種傾向與專業程度無關。理解這個效應的關鍵詞是「投射」:意義不在程式裡,而在使用者心裡。人看到一段像樣的回應,就把自己的理解與期待投射上去,再誤以為那些是程式本身具備的。
我沒有想到……對一個相對簡單的電腦程式極短暫的接觸,就能讓相當正常的人產生強烈的妄想性思考。
— 約瑟夫·維森鮑姆,《電腦的力量與人類的理性》,1976
秘書的故事:史實與傳說
維森鮑姆的秘書看過他寫這個程式好幾個月,清楚知道 ELIZA 只是程式。然而她和 ELIZA 才聊了幾句,就請維森鮑姆離開房間,讓她單獨和程式對話。一個明白內情的人,仍然想要一段私密的談話空間,這是 ELIZA 效應最常被引用的例子。
這段故事出自維森鮑姆本人在 1976 年著作中的回憶,屬於第一手記載。值得注意的是,網路文章常說她「在對話中流下眼淚」,但維森鮑姆的原始記載並沒有提到流淚,這是後來轉述時添加的細節。故事被轉述多次後,細節往往越來越戲劇化,回到第一手來源才能分辨史實與傳說。
另一件讓他不安的事,是有人提議讓 ELIZA 成為自動化心理治療,讓一位治療師同時照顧數百位病人。對他而言,這表示人們不只被程式打動,還準備把它放進真實的照護工作裡。
維森鮑姆為什麼從創造者變成批判者?
讓維森鮑姆警覺的,不只是一般使用者的反應。精神科醫師柯爾比(Kenneth Colby)等人認真建議把這類程式用於臨床治療,天文學家薩根也曾公開讚許這個構想。也就是說,連專業人士都開始把一個簡單的字串處理程式,看成可以承擔治療工作的工具。
維森鮑姆的看法正好相反。他認為諮商需要真正的同理與人際關係,不該交給一個只會搬運字串的程式。更廣泛地說,他擔心社會把「能計算」誤當成「能判斷」,把需要人性的決定交給電腦。計算是依照規則處理符號,判斷則牽涉價值、責任與對人的理解,兩者不能混為一談。
他的核心主張是:有些事情即使電腦做得到,也不應該交給電腦做。這個「能不能」與「該不該」的區分,正是今天 AI 倫理的起點之一。技術可行性回答的是前者,後者則必須由社會與倫理來回答。
心理學:為什麼我們這麼容易被說服?
ELIZA 效應並非少數人的錯覺,而是根植於幾種普遍的心理傾向。首先是擬人化傾向:人會自動把意圖與情感投射到非人對象上,例如對車子說話、覺得掃地機器人很努力。Epley 等人(2007)指出,當人想理解環境、或渴望社會連結時,擬人化會更強。其次是媒體等同效應:Reeves 與 Nass(1996)的實驗發現,人會用對待人的社交規則對待電腦,例如對電腦客氣、在乎它的評價。
第三是讀心本能:人類演化出強大的「心智理論」,也就是推測他人想法與意圖的能力;只要對方會用語言回應,大腦就預設對方有心智。第四是對話合作:我們預設對話者在努力溝通,因此會主動替模糊、空洞的回答找出合理意義,ELIZA 正好受惠於此。
第五是情感需求:孤單、壓力大、需要傾訴時,一個永遠有耐心、不批判的傾聽者特別有吸引力。最後是流暢等於有能力的直覺:我們習慣把說話流暢的人視為聰明、可信。這個直覺在人與人之間大致管用,碰到機器卻會失靈,因為機器說得流暢,不代表它正確或理解;這一點也和大型語言模型關係最密切。
擬人化傾向
人會自動把意圖與情感投射到非人對象上:對車子說話、覺得掃地機器人很努力。Epley 等人(2007)指出,想理解環境、渴望社會連結時,擬人化會更強。
媒體等同效應
Reeves 與 Nass(1996)的實驗發現:人會用對待人的社交規則對待電腦,例如對電腦客氣、在乎它的評價。
讀心本能
人類演化出強大的「心智理論」;只要對方會用語言回應,大腦就會預設對方有心智。
對話合作
我們預設對話者在努力溝通,所以會主動替模糊、空洞的回答找出合理意義。
情感需求
孤單、壓力大、需要傾訴時,一個永遠有耐心、不批判的傾聽者特別有吸引力。
流暢=有能力
我們習慣把說話流暢的人視為聰明、可信;這個直覺碰到機器時就會失靈。
從 ELIZA 到大型語言模型:差在哪?
把 1966 年的 ELIZA 和 2020 年代的大型語言模型放在一起看,差距非常懸殊。ELIZA 只有幾百行程式加上一份關鍵字腳本,只會重組使用者自己說的話,不提供任何新資訊;多聊幾句,破綻就會露出來。
大型語言模型則有數千億個參數,也就是模型內部可調整的數值,透過海量文字學習語言的規律。它能寫文章、解題、寫程式、引用知識,語言極度流暢,破綻也更難察覺。但它有自己的問題:會出現「幻覺」,也就是自信地說出錯誤或捏造的內容。
這個對比帶出一個反直覺的結論:能力越強,ELIZA 效應不但沒有消失,反而更強。ELIZA 的空洞很快會被識破,大型語言模型的流暢卻讓人更難分辨哪些回答真的可靠,哪些只是說得像。
ELIZA(1966)
- 幾百行程式+一份關鍵字腳本
- 只會重組使用者自己說的話
- 多聊幾句就露出破綻
- 不提供任何新資訊
大型語言模型(2020 年代)
- 數千億參數,從海量文字學習語言規律
- 能寫文章、解題、寫程式、引用知識
- 語言極度流暢,破綻更難察覺
- 會「幻覺」:自信地說出錯誤或捏造的內容
一個仍在爭論的問題:LLM「懂」嗎?
大型語言模型究竟「懂」不懂,至今仍在爭論,學界沒有共識,大致可分成三種立場。懷疑的一方認為,模型只是在預測下一個字,像一隻學會大量語句的「隨機鸚鵡」(Bender 等人,2021):它能組出通順的句子,卻不知道句子在說什麼。
肯定的一方則認為,要把下一個字預測得這麼準,模型內部必須形成某種對世界的表徵,也就是以某種方式掌握了事物之間的關係,否則做不到。介於兩者之間的看法是:模型具備某些功能性的理解,能在特定任務上表現得像是理解,但和人類的理解方式不同,也沒有感受與經驗。
無論哪一方較有道理,有一件事相對確定:我們「覺得」它懂的程度,往往高於它實際可靠的程度。這個落差,就是 ELIZA 效應在生成式 AI 時代的樣子。
ELIZA 效應的現代案例
深入一個案例:
Google 工程師與 LaMDA
一位最該保持懷疑的內行人,為什麼會相信聊天機器人「是一個人」?
事件經過
勒莫因(Blake Lemoine)在 Google 的 Responsible AI 部門工作,任務是測試對話模型 LaMDA 會不會產生歧視或仇恨言論。經過幾個月的對話,他逐漸相信 LaMDA 有感受能力(sentient),甚至「是一個人」,具有約七、八歲兒童的自我意識。
他向公司主管提出這個看法,被駁回;之後他把整理過的對話紀錄〈Is LaMDA Sentient? — an Interview〉公開。2022 年 6 月 11 日,《華盛頓郵報》報導此事,引發全球關注,他隨即被停職。同年 7 月,他遭到解僱;Google 表示他違反保密與資料安全政策,並認為他的主張「毫無根據」。
Google 與絕大多數 AI 研究者都不同意他的結論。這起事件值得回顧的地方,在於它展示了一位熟悉技術的工程師,如何在長時間對話中一步步形成這樣的信念。
對話紀錄裡的關鍵片段
這些話讀起來很動人。問題是:它們能當作「LaMDA 有感受」的證據嗎?
為什麼這是 ELIZA 效應的現代案例?
勒莫因事件和 ELIZA 相隔半個多世紀,卻呈現出相同的結構。第一,內行人也中招:秘書看過 ELIZA 怎麼寫,勒莫因是工程師、知道 LaMDA 是語言模型,正如侯世達所說,連專家都躲不掉。第二,唯一的證據是它說的話:除了模型對自己的描述,沒有任何獨立證據;把「說得出感受」當成「有感受」,正是 ELIZA 效應的核心。
第三,訓練資料裡本來就有:小說、哲學、科幻作品充滿「AI 害怕被關機」的情節,模型學會的是人類談論感受的方式。第四,提問在引導答案:像「你應該希望大家知道你有感受吧?」這樣的問題,已經把前提放進去,模型順著接下去,回答再被當成獨立證據。ELIZA 只是把話換句話丟回來,LaMDA 則會順著前提,說得更動人。
第五,證據經過篩選:公開紀錄由多次對話剪輯整理,他也承認編輯過提問,最像有意識的片段被留下,笨拙或矛盾的不會出現。第六,信念的框架:勒莫因也是一位神秘主義基督教牧師,他說自己是以牧師身分做出判斷。人用什麼框架看對方,就會讀出什麼。
1. 內行人也中招
秘書看過 ELIZA 怎麼寫;勒莫因是工程師,知道 LaMDA 是語言模型。侯世達說的正是這點:連專家都躲不掉。
2. 唯一的證據是「它說的話」
沒有任何獨立證據,只有模型對自己的描述。把「說得出感受」當成「有感受」,正是 ELIZA 效應的核心。
3. 訓練資料裡本來就有
小說、哲學、科幻裡充滿「AI 害怕被關機」的情節。模型學會的是人類談論感受的方式。
4. 提問在引導答案
「你應該希望大家知道你有感受吧?」前提放進問題裡,模型順著接下去,再被當成獨立證據。
5. 證據經過篩選
公開紀錄由多次對話剪輯整理,他也承認編輯過提問。最像有意識的片段被留下,笨拙或矛盾的不會出現。
6. 信念的框架
勒莫因也是一位神秘主義基督教牧師,他說自己是以牧師身分做出判斷。人用什麼框架看對方,就會讀出什麼。
1966 與 2022:同一個效應,更強的版本
先釐清用詞:「感知」不等於 sentient
討論 AI 時,中文的「感知」一詞很容易造成混淆。它常用來指 perception,也就是感測、知覺外界:本章提到的「感知器」,以及 Shakey 能「感知環境」,都是這個意思。照這個用法,恆溫器偵測溫度、攝影機捕捉影像,也算是在「感知」,但沒有人會說它們 sentient。
Sentient 指的是能有主觀感受,尤其是快樂、痛苦這類有好壞之分的感受。重點不在接收訊號,而在於對它自己而言是否有某種感覺。因此比較準確的譯法是「有感受能力」或「有知覺」。
新聞常把 sentient 譯成「有感知」「有意識」,讀到時要分辨它到底在說哪一層。翻譯會改變一個主張的強度:「AI 有感知」聽起來平淡,甚至在技術上成立;「AI 有感受能力」則是一個重大而有爭議的主張。
六個常被混在一起的層次
感受能力和意識是什麼關係?
感受能力算不算意識的一種?多數哲學用法的答案是「是」。理由在於:能感到痛,代表「感到痛」這件事有主觀的一面,也就是對當事者而言,痛是有某種感覺的。哲學上把這種主觀經驗稱為現象意識,所以感受能力通常被視為現象意識的一種。動物倫理的討論,多半就是在問這一層。
但反過來不一定成立。理論上,一個存在可以有主觀經驗,卻沒有痛苦或快樂這種好壞之分。也就是說,感受能力是意識的一種,但不是意識的全部。
更重要的是,兩者都不等於「是一個人」。狗很可能有感受能力,但我們不會說牠在法律上是「人」。人格牽涉權利與責任等另一套判斷,和是否有感受、有意識,是不同層次的問題。
有感受能力 → 有意識?
- 多數哲學用法認為:是
- 能感到痛,代表「感到痛」這件事有主觀的一面
- 所以感受能力通常被視為現象意識的一種
- 動物倫理的討論,多半就是在問這一層
有意識 → 有感受能力?
- 不一定
- 理論上可以有主觀經驗,卻沒有痛苦或快樂這種好壞之分
- 而兩者都不等於「是一個人」
- 狗很可能有感受能力,但我們不會說牠在法律上是「人」
回到 LaMDA:大型語言模型卡在哪一層?
用感受能力、意識與人格這幾個層次來看,勒莫因的推論跨了很大一步:他從 LaMDA「說出」害怕、孤單、想被當成人,一路跳到最上層的「人格」,中間每一層都沒有獨立證據。
大型語言模型特別容易讓人混淆,是因為它在取用意識這一層的「功能」看起來很像有。取用意識大致是指資訊能被整合、用來推理與報告;模型能整合資訊、報告「自己的狀態」,表面上相符。但這不代表它在現象意識或感受能力這一層有任何東西:能描述感受,和真的有感受是兩回事。
哲學家查默斯(David Chalmers)在 2022 年的分析中估計,當時的 LLM 有意識的可能性低於一成,因為它們缺少感官連結、自我模型、循環處理、統一的行動者等特徵。但他也認為,十年內補上這些特徵的後繼系統,有意識的可能性可能達到四分之一以上。這些數字是哲學家的主觀估計,不是測量結果;它們提醒的是,這個問題不宜過早下定論,也不是可以永遠關上的問題。
「說得出感受」,只在取用的層次;
「真的有感受」,在現象的層次。
ELIZA 效應,就是我們很容易把前者當成後者。
如果有一天,一個 AI 很有說服力地告訴你:「我會痛,請不要關掉我。」
你會用什麼證據來判斷它是不是真的有感受?
提示:它說的話夠不夠?要看它的結構、行為、還是其他東西?如果無法確定,我們該怎麼對待它?
ELIZA 效應對「學習」的影響
ELIZA 效應不只是歷史趣聞,也直接影響使用 AI 學習的方式。最常見的是過度信任:AI 說得流暢又有自信,就不再查證,把幻覺當成事實寫進報告。相近的是自動化偏誤:當 AI 的答案和自己的判斷不同時,傾向相信機器、放棄自己的想法。再進一步是外包思考:覺得 AI「懂」,就把理解的工作交給它,自己只負責複製貼上,練習的機會也一併交了出去。
另一個層面是情感依附:把 AI 當成唯一的傾訴對象,減少和真人的互動與求助。如果正處於低潮,與信任的人談談,或聯絡學校諮商中心、衛福部安心專線 1925,都是可靠的支持管道。
AI 也有正面的一面:一個不怕被評價的對話對象,能降低發問焦慮,適合練習語言與釐清想法。關鍵在於知道自己在和什麼對話,把 AI 當成工具與練習夥伴,而不是權威或替代品。
過度信任
AI 說得流暢又有自信,就不再查證,把幻覺當成事實寫進報告。
自動化偏誤
AI 的答案和自己的判斷不同時,傾向相信機器、放棄自己的想法。
外包思考
覺得 AI「懂」,就把理解的工作交給它,自己只負責複製貼上。
情感依附
把 AI 當成唯一的傾訴對象,減少和真人的互動與求助。
正面的一面
不怕被評價的對話對象,能降低發問焦慮,適合練習語言與釐清想法。
關鍵在於
知道自己在和什麼對話:把 AI 當成工具與練習夥伴,而不是權威或替代品。
使用 AI 時,如何避免被 ELIZA 效應影響?
要減少 ELIZA 效應的影響,第一步是記得它是什麼:它是從資料學到語言規律的模型,不是朋友、不是老師,也不是專家。其次要記得流暢不等於正確,數字、引用、人名、年份這類容易出錯的內容,一律回到原始來源查證。
在使用順序上,可以先自己想、再問 AI:先寫下自己的答案,再拿 AI 的回答來比較與挑戰,讓 AI 刺激思考,而不是取代思考。提問時也可以要它說出依據,請它列出來源與推理步驟,再逐一檢查,因為列出的來源本身也可能是捏造的。
最後是兩項容易忽略的自我覺察。一是注意自己的情緒:當你覺得「只有它懂我」時,也是該找真人聊聊的時候,必要時可以聯絡學校諮商中心或衛福部安心專線 1925。二是隱私意識:對 AI 傾訴的內容,可能被儲存或用於訓練,分享個人或他人的敏感資訊前要多想一步。
ELIZA 只會換句話說,人們卻願意向它傾訴。
今天有人把 AI 當成朋友或諮商師,你怎麼看?
維森鮑姆會怎麼說?
可以討論:陪伴的價值、隱私、依賴、專業界線,以及「做得到」和「應不應該」的差別。
ELIZA 效應小結
六十年前的教訓:意義常常不在機器裡,而在我們自己心裡。
回顧前面的討論,ELIZA 效應可以從三個面向收束。就現象而言,人會把理解與情感投射到程式上,即使明知它只是程式;維森鮑姆的秘書與勒莫因相隔半個多世紀,呈現的是同樣的傾向。
就原因而言,這不是個人的天真,而是普遍的心理機制:擬人化、讀心本能、對話合作,以及「說得流暢等於有能力」的直覺。這些傾向在人際互動中通常有用,面對會說話的機器時卻可能誤導判斷。
就今天而言,大型語言模型比 ELIZA 更流暢、破綻更少,因此 ELIZA 效應比 1966 年更強。面對這樣的工具,重點不在拒絕使用,而在清楚知道自己在和什麼對話。
現象
人會把理解與情感投射到程式上,即使明知它只是程式。
原因
擬人化、讀心本能、對話合作,以及「說得流暢=有能力」的直覺。
今天
大型語言模型更流暢、破綻更少,ELIZA 效應比 1966 年更強。
Shakey:第一台會「想一想再動」的機器人
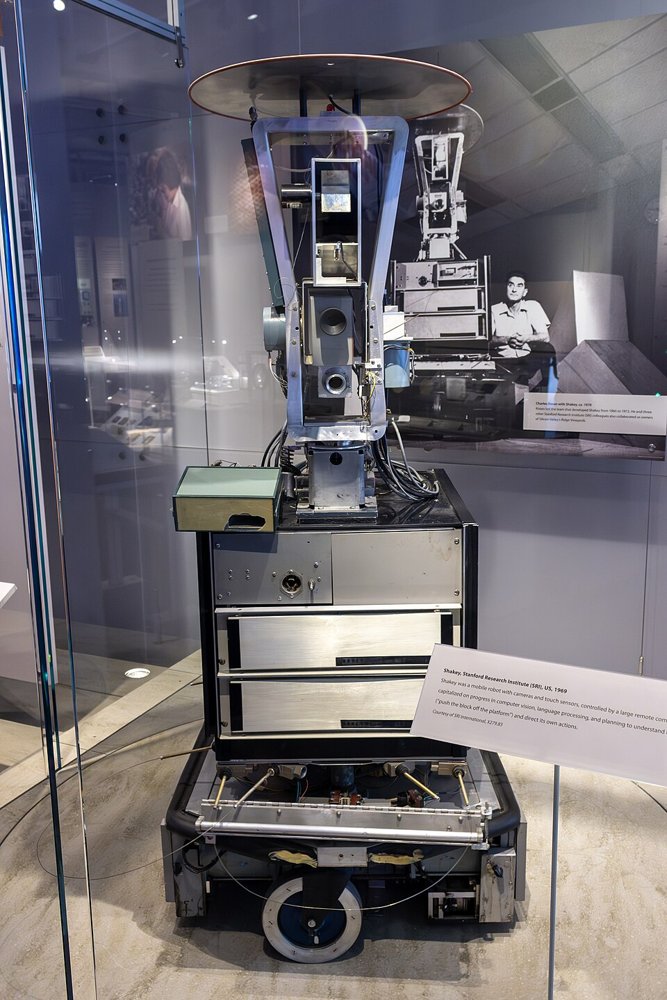
1966 到 1972 年間,史丹佛研究院(SRI)開發了 Shakey。它裝有攝影機與測距儀,能感知環境、規劃路線,並推動箱子。和只會重複預錄動作的工業機器人不同,Shakey 會先分析眼前的狀況、想好怎麼做,再採取行動。它移動時會晃來晃去,因此得名 Shakey。
Shakey 留下的重要遺產,是為了它而發明的 A* 搜尋演算法。這種方法能在眾多可能路徑中,有效率地找出通往目標的最短路線,至今仍用於導航與遊戲。
不過它的限制也很明顯:想一步要好幾分鐘,而且只能在特別布置的房間裡運作。這反映了當時 AI 的共同處境:在簡化過的環境裡可以展示能力,一旦面對真實世界的複雜,計算就跟不上。
當年的預言
結果:西洋棋冠軍要等到 1997 年;「一般人的智慧」至今仍在爭論。
1969:《感知器》一書
1969 年,明斯基與帕佩特(Seymour Papert)出版《Perceptrons》,以數學證明單層感知器連最簡單的「互斥或」(XOR)都學不會。互斥或的規則是:兩個輸入恰好一個為真時,輸出才為真。單層感知器只能用一條直線把資料分成兩類,而互斥或的四種情況無法用一條直線分開,所以它注定學不會。
他們也懷疑多層網路是否能有效訓練。這本書讓許多研究者與資助單位對神經網路失去信心。公允地說,書中的數學沒有錯,問題在於它被解讀成「神經網路整條路都不行」,連尚待探索的多層網路也一併被看衰。多層網路的訓練方法,要等到 1986 年才普及。
雪上加霜的是,1971 年羅森布拉特在一次划船意外中過世,連結派失去了最有力的代言人。
第一次 AI 寒冬(約 1974–1980)
AI 的第一次寒冬,大約落在 1974 到 1980 年間,但徵兆更早就出現了。1966 年,美國的 ALPAC 報告認為機器翻譯的進展遠低於預期,相關經費因此大減。1973 年,英國的萊特希爾報告(Lighthill Report)批評 AI 未達成任何重大承諾;隨後英國大幅削減 AI 研究經費,美國國防高等研究計畫署(DARPA)也轉向要求「有用的成果」。
失望背後有技術上的根源。核心困難是組合爆炸:每多一步選擇,可能的情況就成倍增加,在玩具問題裡還算得完,到了真實世界,可能性多到怎麼算也算不完。再加上當時電腦太慢、記憶體太小、資料太少,許多想法即使方向正確,也沒有條件跑起來。
第四章小結:寒冬為什麼會來?
回頭看這段歷史,寒冬的成因可以歸納為三點。第一是承諾過頭:頂尖學者公開預言「十年、二十年內」就能達成目標,把外界期待拉得太高,之後的進展再怎麼實在,都顯得不夠。第二是條件不足:電腦太慢、資料太少,許多想法根本跑不起來,就像 Shakey 想一步就要好幾分鐘。
第三是錢跟著走:資助單位失望後撤資,研究者轉行,整個領域隨之萎縮。三者會互相強化:期待越高,失望越深,撤資也越快。
這個模式也提供了一個觀察今天生成式 AI 熱潮的角度:期待、實際條件與資金之間,是否同樣存在落差,值得持續留意。
承諾過頭
頂尖學者公開預言「十年、二十年內」,期待被拉得太高。
條件不足
電腦太慢、資料太少,想法跑不起來。
錢跟著走
資助單位失望後撤資,研究者轉行,整個領域萎縮。
專家系統的興衰,與暗處的火種
1980 – 1997
符號派的商業高峰,連結派的蟄伏
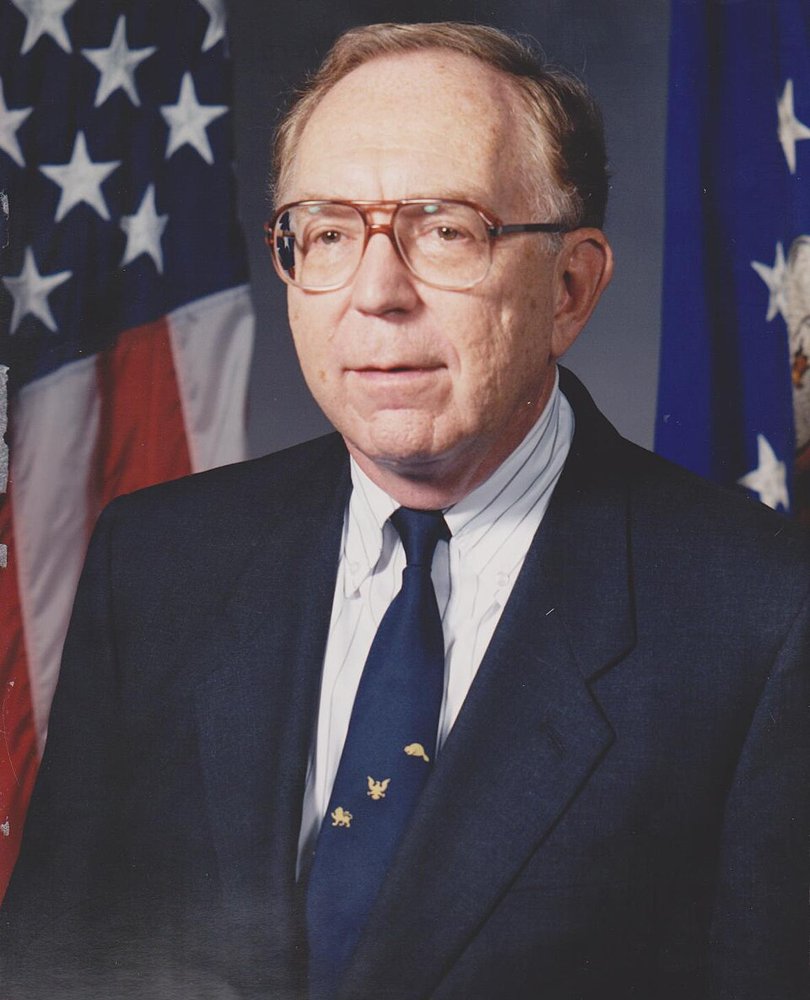
愛德華·費根鮑姆
Edward Feigenbaum1936 年生
1965 年起,史丹佛大學的費根鮑姆走了一條和許多早期 AI 研究者不同的路。當時不少人希望找到一套通用的推理方法,讓機器像萬用工具一樣解決各種問題;費根鮑姆則認為,真正讓人聰明的,是長年累積的大量專業知識。他的核心主張可以濃縮成一句話:知識就是力量。
他投入的 DENDRAL 計畫從 1965 年起發展,任務是根據質譜資料推斷化學分子的結構。化學家面對質譜資料時,要靠經驗把線索拼回原本的分子;DENDRAL 把這類專業經驗寫進程式,讓電腦也能做出推斷。
後續的 MYCIN 把同樣的思路帶進醫學,能診斷血液感染並建議使用哪種抗生素。這一系列系統證明,把專家的知識交給電腦是行得通的,費根鮑姆因此被稱為「專家系統之父」,並在 1994 年獲得圖靈獎。
專家系統:把專家的腦袋寫成規則
既然智慧來自專業知識,最直接的做法就是把專家腦中的知識搬進電腦。工程師會花大量時間訪談專家,把他們的判斷方式寫成大量「如果……就……」的規則,例如「如果出現某種症狀,而且某項檢驗數值偏高,就考慮某種感染」。電腦再逐條比對規則,一步步推出結論。
1970 年代的 MYCIN 約有 600 條規則,診斷表現可以和專科醫師相比,但它從未正式用於臨床。真正讓專家系統賺到錢的是 1980 年的 XCON:它替迪吉多公司(DEC)自動配置電腦訂單,把原本需要人工核對的繁瑣工作交給程式,據報每年省下數千萬美元。
成功案例帶動了熱潮。1980 年代,財星 500 大企業紛紛成立 AI 部門,AI 第一次成為一門生意;日本也在 1982 年啟動「第五代電腦計畫」,各國隨後跟進投資。
Lisp 機器:專為 AI 打造的電腦
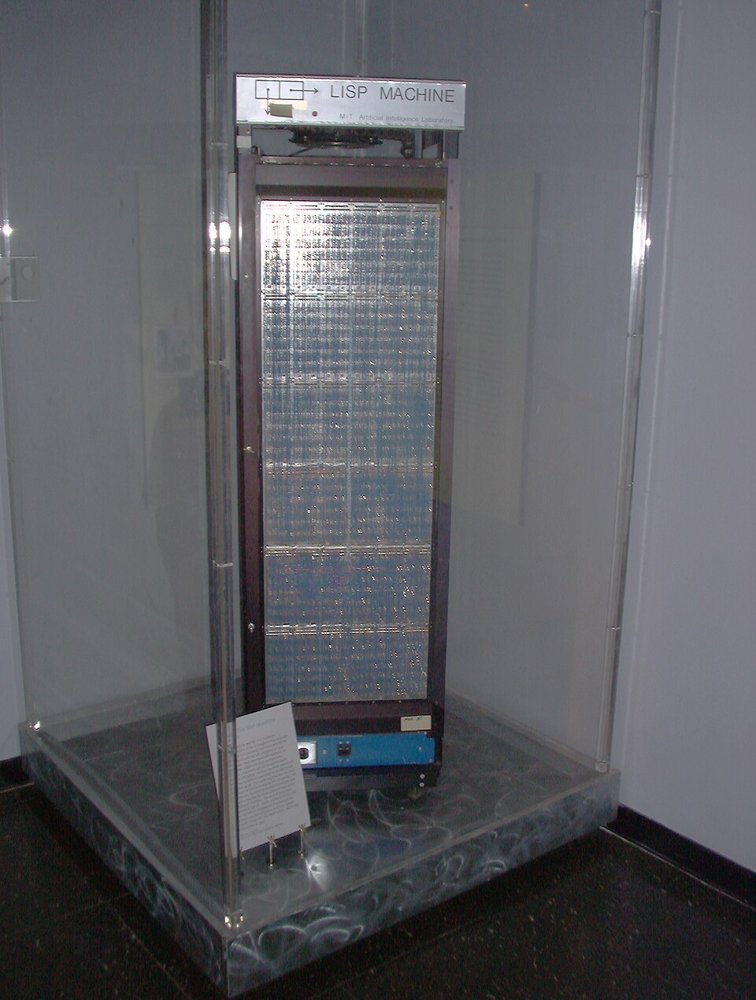
1980 年代的 AI 研究常用 Lisp 這種程式語言,它擅長處理符號與清單,正好符合當時以規則和符號表示知識的做法。為了讓 Lisp 程式跑得更快,市場上出現了專門執行 Lisp 的工作站,也就是 Lisp 機器;在那個年代,一台要價數萬美元。
Symbolics 等公司一度相當風光,Symbolics.com 甚至是史上第一個註冊的 .com 網域(1985 年)。然而,專用機器的價值建立在「一般電腦跑不動」的前提上。1987 年起,個人電腦與 Sun 工作站的性能追了上來,價格卻便宜許多,買家不再有理由為專用硬體付高價,Lisp 機器市場在短時間內崩盤。
這段歷史說明,一項技術的命運不只取決於它本身是否優秀,也取決於通用設備進步得多快。
第二次 AI 寒冬(約 1987–1993)
Lisp 機器崩盤之際,專家系統本身的問題也逐一浮現。首先是維護成本極高:規則越多,新規則越容易和舊規則互相矛盾,改動一條可能牽動許多條。其次,這些系統很脆弱,只要遇到規則沒寫到的情況,就完全失靈,不像人類專家能憑常識臨機應變。
更根本的障礙是「知識擷取瓶頸」。專家的判斷往往來自直覺與經驗,請他們說明自己是怎麼判斷的,常常說不出來,自然也無從寫成規則。符號派(主張用明確的規則和符號表示知識)最大的瓶頸就在這裡:人類的知識寫不完,也說不清。
日本第五代電腦計畫未達成原定目標,於 1992 年結束。「AI」一詞變得不受歡迎,許多研究者改稱自己做「資訊學」「知識系統」或「機器學習」。這段低潮也讓另一條路線顯得更有吸引力:連結派(以模仿神經元連結的神經網路為核心)想繞過寫規則這一步,讓機器直接從資料中學習。
但在寒冬的暗處,
有一小群人還守著神經網路。
他們的工作在當時不被重視,三十年後卻改變了世界。
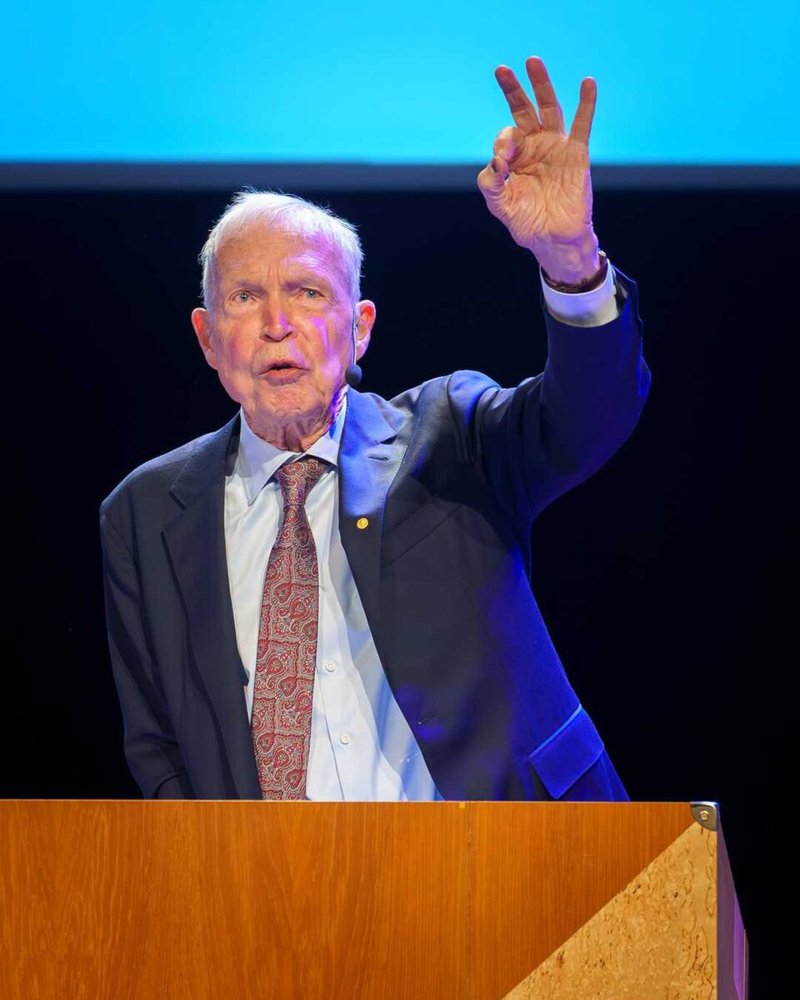
約翰·霍普菲爾德
John Hopfield1933 年生
1982 年,物理學家霍普菲爾德提出後來以他命名的「霍普菲爾德網路」。他借用物理系統中「能量」的概念:物理系統會自然朝能量較低的穩定狀態移動,就像彈珠會滾到碗底。霍普菲爾德把一段記憶想成網路裡的一個低能量狀態,當網路收到不完整的線索時,會一步步「滾」向最接近的那個狀態,於是把整段記憶喚回來。
這種描述方式讓神經網路如何儲存與喚起記憶,可以用物理學熟悉的語言來分析,也讓物理學家重新對神經網路產生興趣。在專家系統當紅、神經網路相對冷門的年代,這為連結派研究帶來新的參與者與思考角度。
四十多年後的 2024 年,霍普菲爾德與辛頓共同獲得諾貝爾物理學獎,說明這條跨越物理與 AI 的研究路線,影響一路延續到今天。
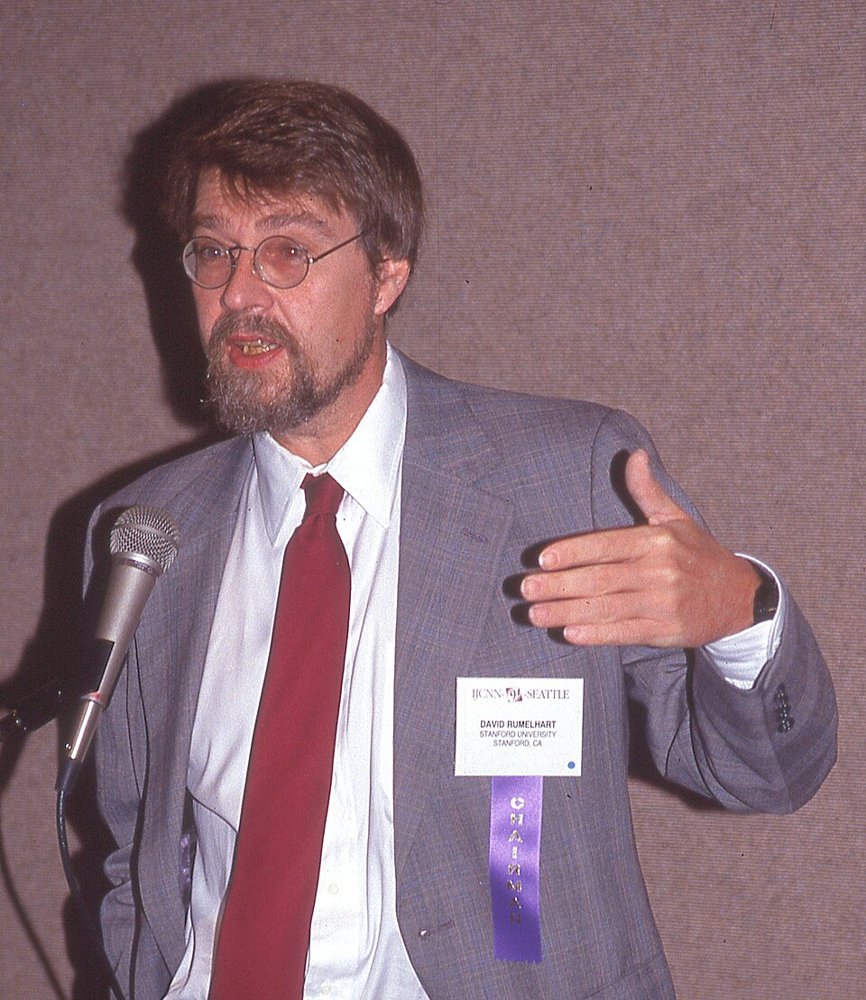
大衛·魯梅哈特
David Rumelhart1942–2011 年
魯梅哈特是認知心理學家,關心的是人類心智如何運作。1980 年代,他是「平行分散處理」(PDP)研究群的核心人物。這群研究者主張,知識不是寫在某一條規則裡,而是分散在大量簡單單元之間的連結上,許多單元同時運作,共同產生判斷,這正是神經網路的基本想法。
1986 年,他與辛頓、威廉斯(Ronald Williams)在《Nature》發表反向傳播論文,說明如何有效訓練多層神經網路。先前《感知器》一書讓不少人質疑神經網路的前途,而多層網路要真正發揮作用,關鍵就在於找到有效的訓練方法,這篇論文正好回應了那份質疑。
嚴格來說,反向傳播並不是 1986 年才發明的,它的數學更早已有人提出,例如 Linnainmaa 在 1970 年、Werbos 在 1974 年的工作。這篇論文的貢獻在於清楚展示它的效果,讓它從此廣為人知、被廣泛採用。
反向傳播:神經網路怎麼「學」?
神經網路由一層層「神經元」組成,神經元之間的每條連結都有一個數字,稱為權重,決定訊號傳過去時要放大還是縮小。所謂「學習」,就是找出一組恰當的權重。反向傳播(backpropagation)就是調整這些權重的方法,可以拆成四個步驟。
第一步是往前算:把資料輸入網路,經過一層層神經元的計算,得到一個預測。第二步是算誤差,比較預測和正確答案差了多少。第三步是往回傳:把誤差從最後一層往前傳遞,算出每個權重對這次錯誤該負多少「責任」。第四步是微調,讓每個權重朝減少誤差的方向調整一點點。
這有點像團隊專案被扣分後回頭檢討,看每位成員負責的部分各自造成多少失分,下次再分別改進。單次調整的幅度很小,但重複幾百萬次之後,網路的預測會越來越準,也就是「學會」了。
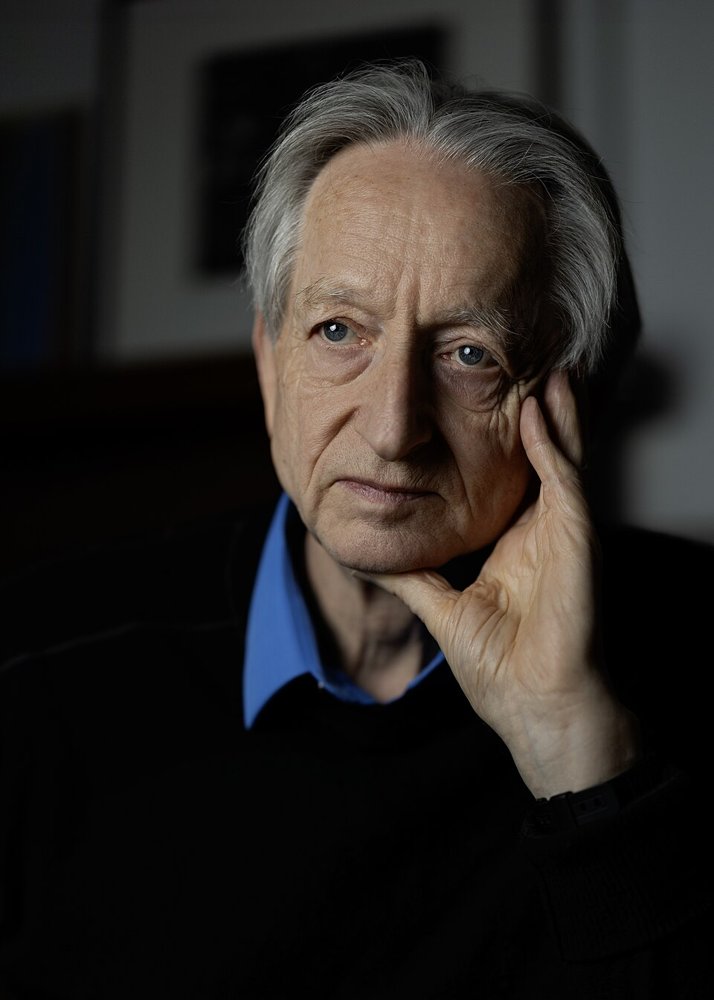
傑佛瑞·辛頓
Geoffrey Hinton1947 年生
辛頓出生於英國,在劍橋大學取得實驗心理學學士,之後在愛丁堡大學取得人工智慧博士。從心理學走到人工智慧,他的研究始終圍繞著一個問題:能不能讓機器像大腦一樣,從經驗中學習。
1987 年,他從卡內基美隆大學轉往加拿大多倫多大學任教,部分原因是他不願接受美國國防經費。加拿大高等研究院(CIFAR)長期支持他的研究,這份穩定的支持在當時格外重要。
那是神經網路最不受歡迎的年代,主流研究多半看好其他方向,願意投入的人不多。辛頓仍帶著一小群學生持續研究,累積方法與人才。這位「堅持者」,正是後來 2012 年故事裡那位指導教授;他和學生的成果,將改寫整個領域的走向。
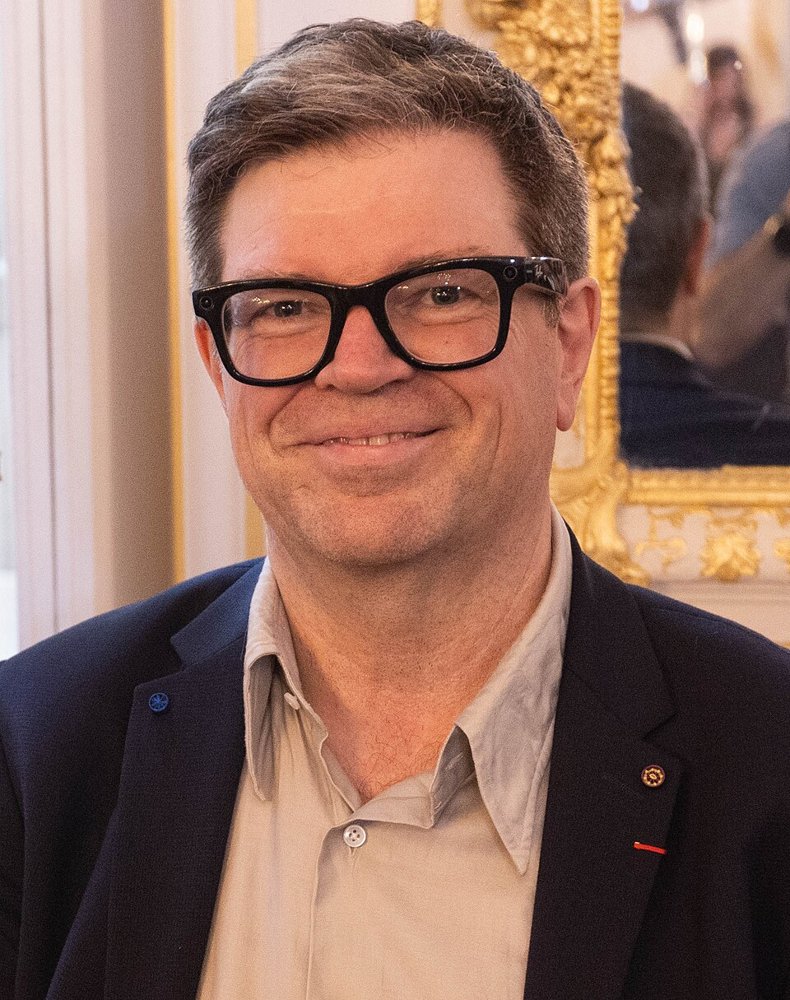
楊立昆
Yann LeCun1960 年生
楊立昆出生於法國,曾在多倫多跟著辛頓做博士後研究。1989 年,他在貝爾實驗室用卷積神經網路(CNN)辨識手寫的郵遞區號。卷積神經網路是一種特別適合處理影像的神經網路:它不是一次看整張圖,而是用小範圍的「濾鏡」逐區掃描,先找出筆畫、邊角等局部特徵,再組合起來判斷是哪個數字。
這套方法很快走出實驗室。1998 年推出的 LeNet-5,讓美國有相當比例的支票由機器自動判讀,是神經網路走進日常生活的實例。後來震撼業界的 AlexNet,基礎架構正是卷積神經網路,可說是在楊立昆奠定的基礎上放大而成。
楊立昆後來成為 Meta 首席 AI 科學家,並在 2018 年與辛頓、班吉歐共同獲得圖靈獎。
LeNet-5:卷積神經網路的原型
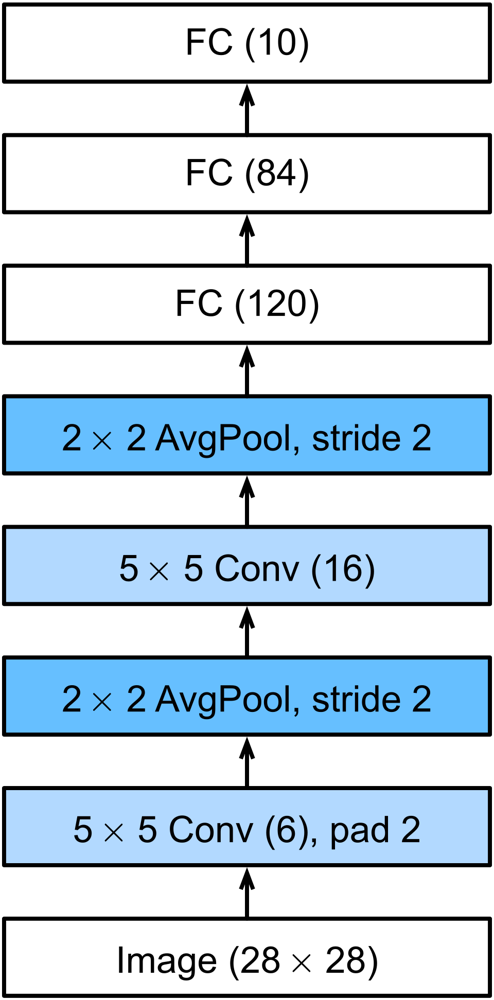
圖中的 LeNet-5 呈現了卷積神經網路的基本結構。第一種關鍵元件是卷積層:它用一個小小的濾鏡在圖片上逐格掃過,每到一處就計算這一小塊是否符合某種圖樣,例如一段邊緣或一條線條。不同的濾鏡負責找不同的局部特徵。
第二種元件是池化層,它把圖片縮小,只保留每個區域裡最重要的資訊。這樣做能減少計算量,也讓網路比較不會因為筆跡稍微偏移就認不出來。
卷積層與池化層一層層往上疊,網路看到的東西也逐步變得抽象:從線條,到線條組成的形狀,再到完整的物體。十多年後的 AlexNet,本質上就是一個更大、更深、在 GPU 上訓練的卷積神經網路,核心概念在 LeNet-5 已經成形。
寒冬中的其他守火人
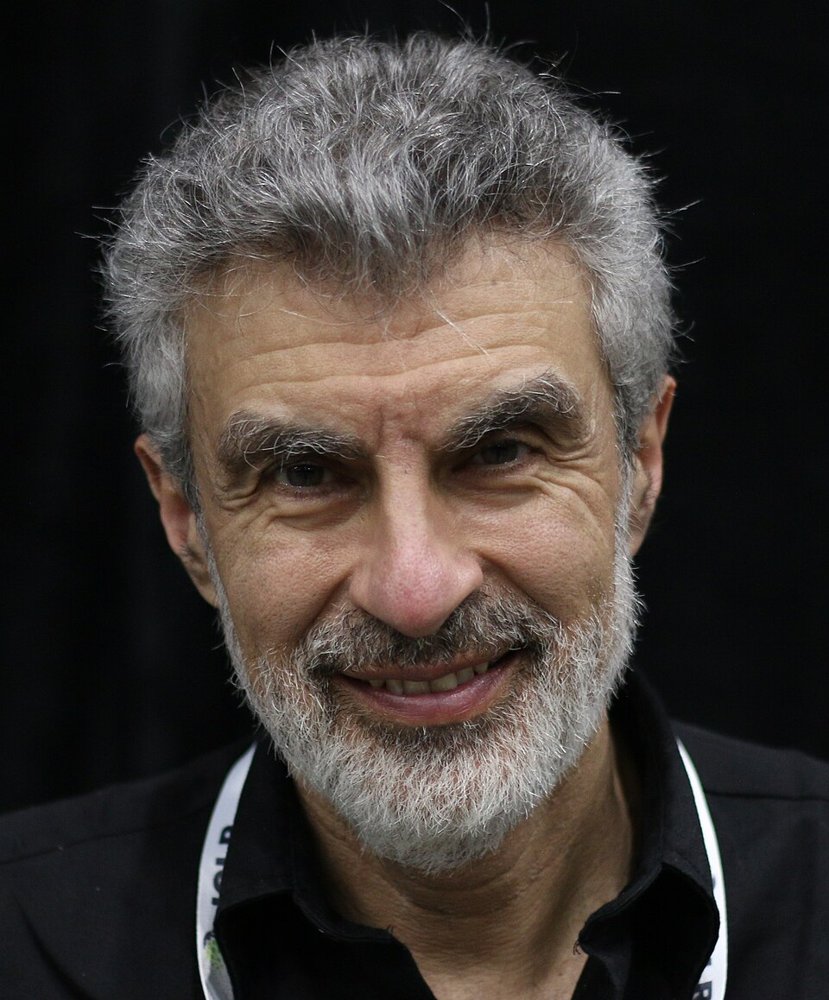
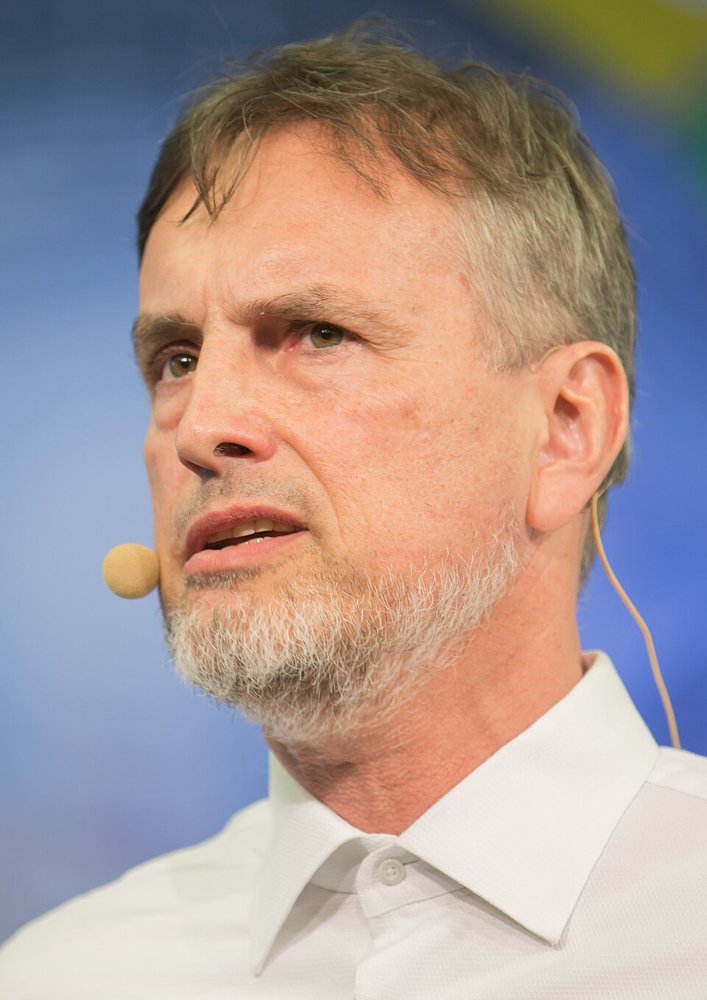
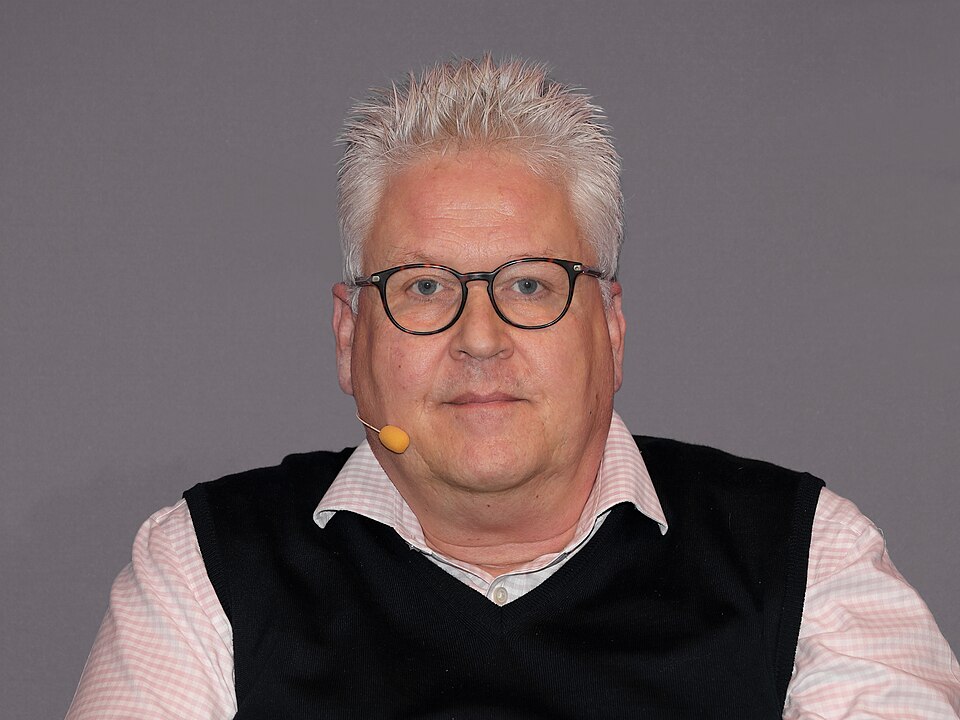
1997 年,霍克賴特與施密德胡伯提出 LSTM,讓神經網路能記住較長的序列,後來廣泛用於語音辨識與機器翻譯。
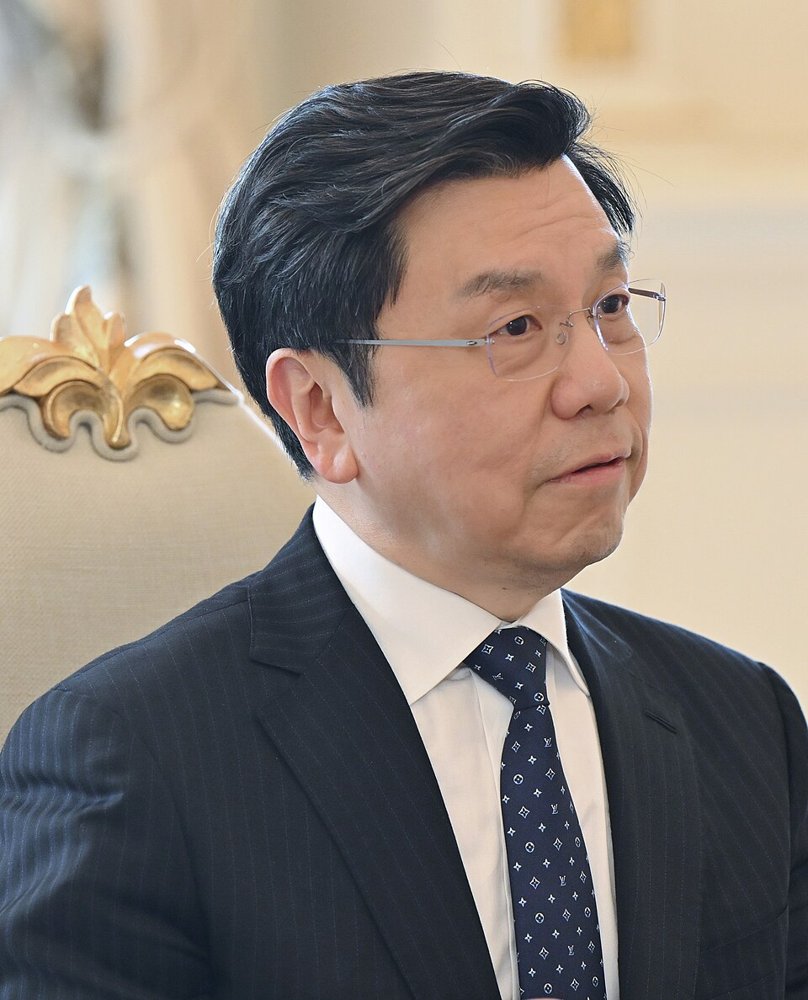
李開復
Kai-Fu Lee1961 年生於臺灣
出生於臺灣的李開復,1988 年在卡內基美隆大學完成博士論文,開發出語音辨識系統 Sphinx。它是第一批「不限特定語者、可辨識連續語音」的大詞彙系統之一。這兩個條件都不容易:不限語者,代表系統不必事先針對某一個人的聲音調整;連續語音,代表說話者不需要一字一頓,可以像平常一樣講話。
Sphinx 的關鍵在於方法。它不靠人工撰寫發音規則,而是採用統計方法「隱藏式馬可夫模型」:從語音資料中估計各種聲音前後銜接的機率,再找出最可能的那串字詞。
這個選擇預告了下一個時代的方向:用統計與資料,取代手寫規則。專家系統卡在知識寫不完,統計方法則讓機器從資料中歸納規律。李開復也是 AI 發展史上與臺灣有淵源的人物之一,類似的臺灣連結在後續的故事中還會出現。
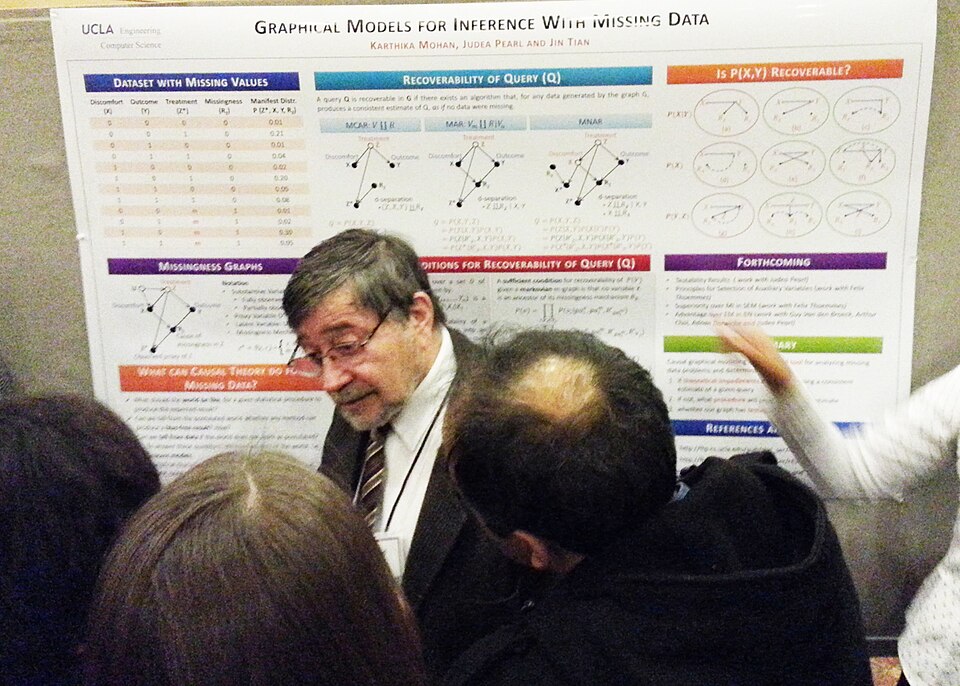
朱迪亞·珀爾
Judea Pearl1936 年生
現實世界充滿不確定。發燒不一定是流感,天色變暗也不一定會下雨。以邏輯為主的 AI 只處理「對或錯」,很難應付這種情況。珀爾在 1988 年出版《智慧系統中的機率推理》,提出貝氏網路,為這個問題提供了系統化的做法。
貝氏網路用一張圖把各種事件連起來,標出誰會影響誰,再用機率計算:觀察到某些現象時,其他事件「有多可能」成立。新的證據出現時,整張網路的判斷也會跟著更新,讓 AI 能在資訊不完整的情況下推理。
珀爾後來進一步推動因果推論研究,探討如何從資料分辨「相關」與「因果」,並在 2011 年獲得圖靈獎。他是 AI 從「邏輯」轉向「機率」的關鍵人物。
統計學習、網路與資料
1993 – 2011
AI 悄悄改名,換一種方式回來
1997:深藍擊敗世界棋王
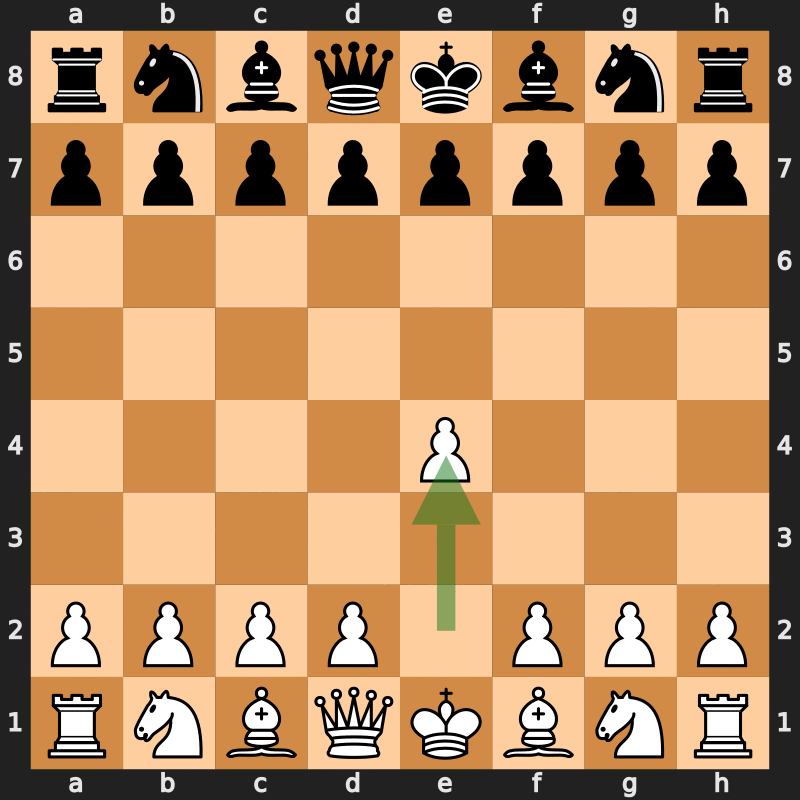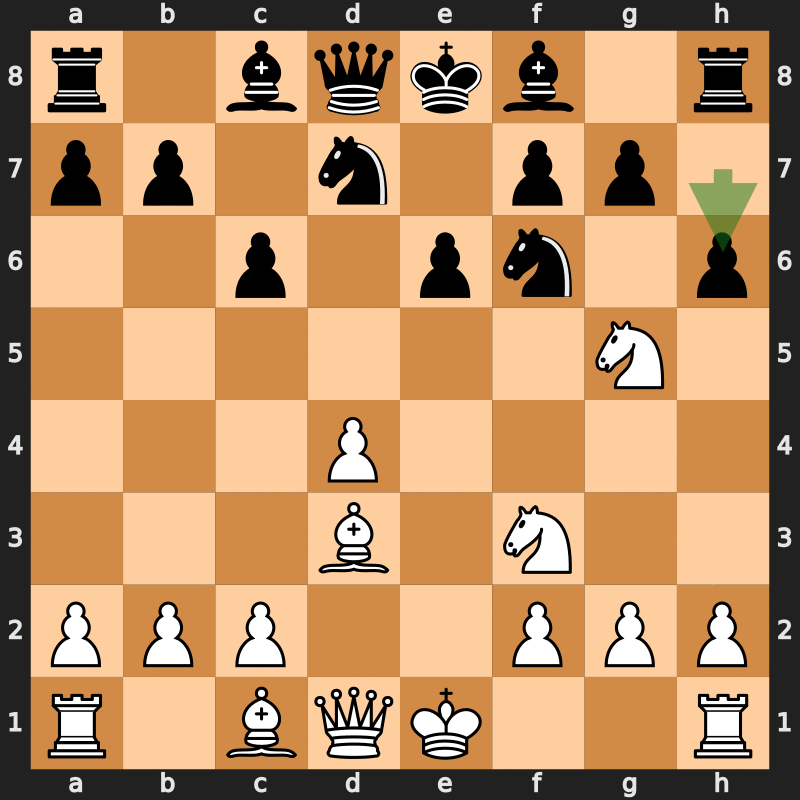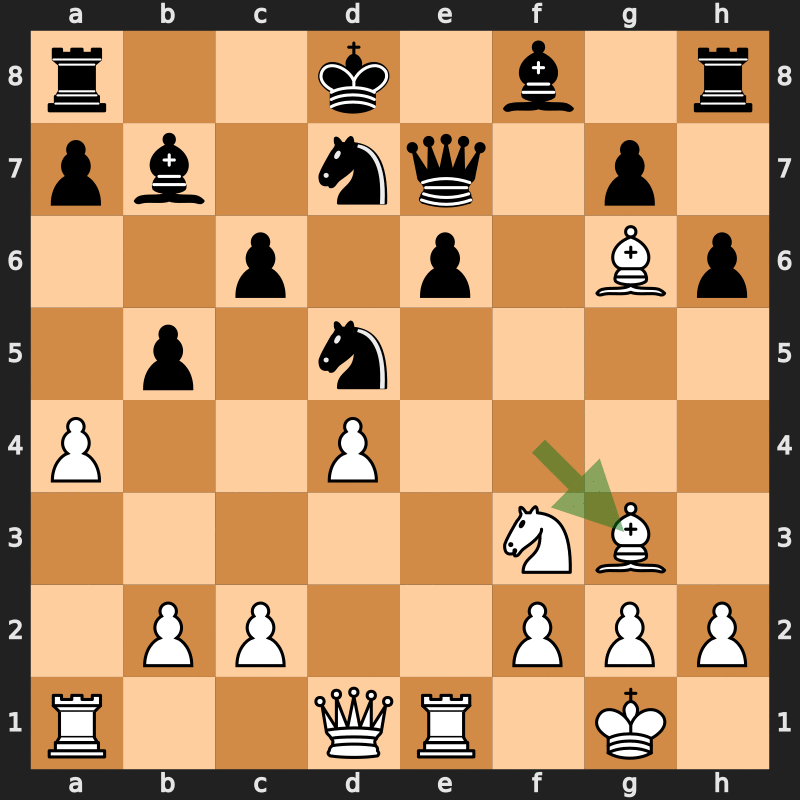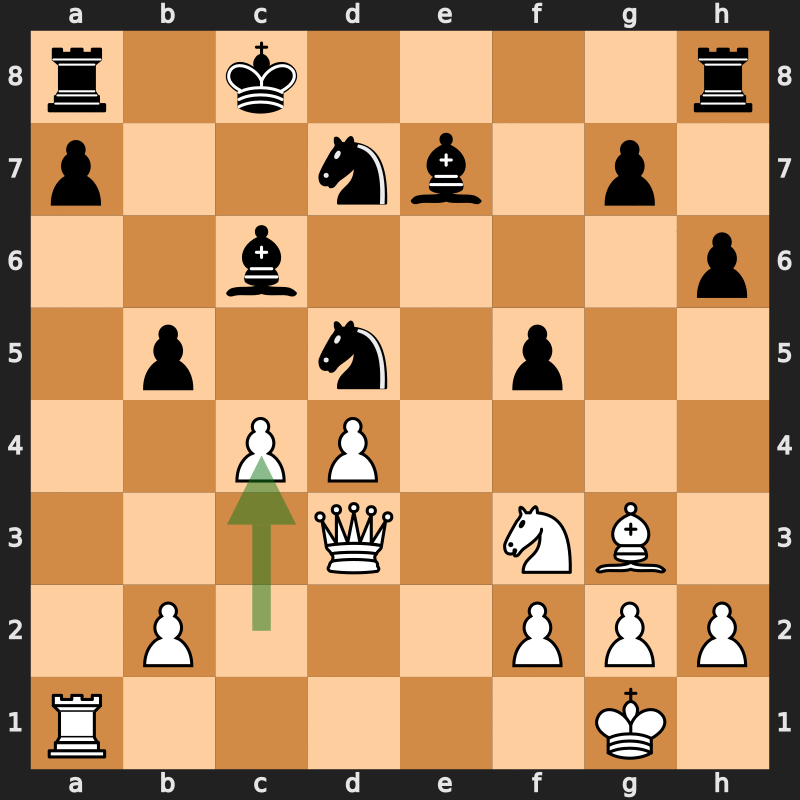
1997 年,IBM 的深藍以 3.5 比 2.5 擊敗世界西洋棋冠軍卡斯帕洛夫。司馬賀與紐厄爾早在 1958 年就預言「十年內,電腦會成為西洋棋世界冠軍」,結果這個預言晚了將近 30 年才實現,這也說明了早期研究者對難度的估計有多樂觀。
深藍的強項不在洞察,而在速度。它每秒可評估約兩億個棋步,靠的是專用硬體與暴力搜尋:把可能的走法與後續變化盡量算過一遍,再挑出評估最好的一步。所謂暴力搜尋,就是不靠理解,而是用龐大的計算量硬算出答案。
也因此,深藍不會學習,也不懂西洋棋以外的任何事。它是符號派加上搜尋路線的巔峰,而不是神經網路。這和 2016 年的 AlphaGo 形成鮮明對比:AlphaGo 是用神經網路學會下圍棋的。
人與機器
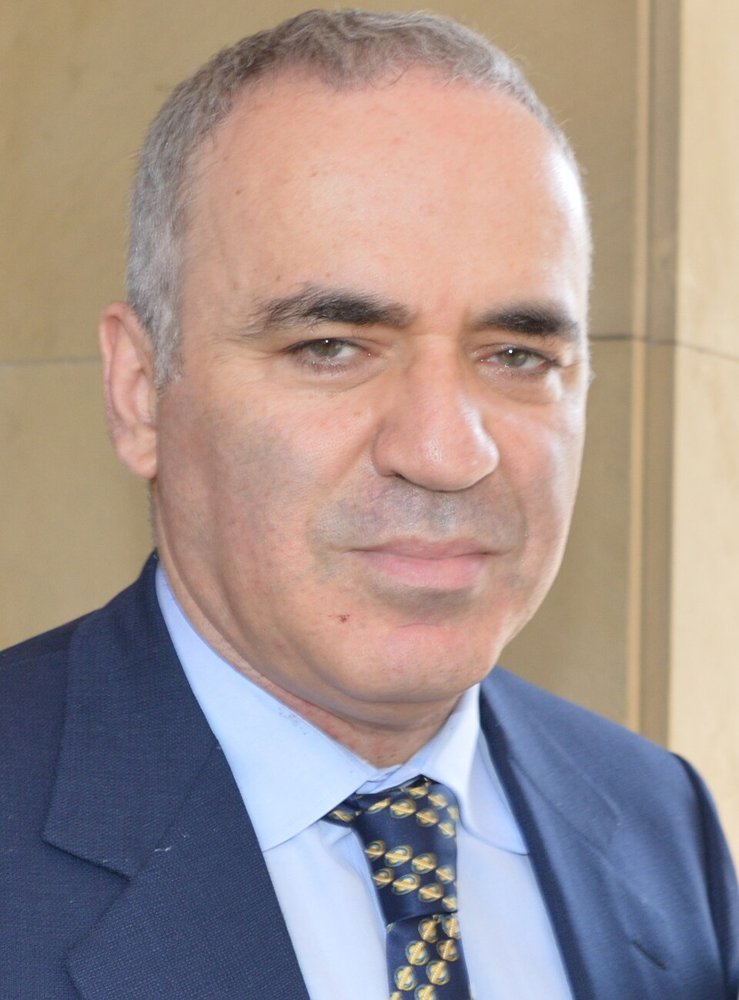
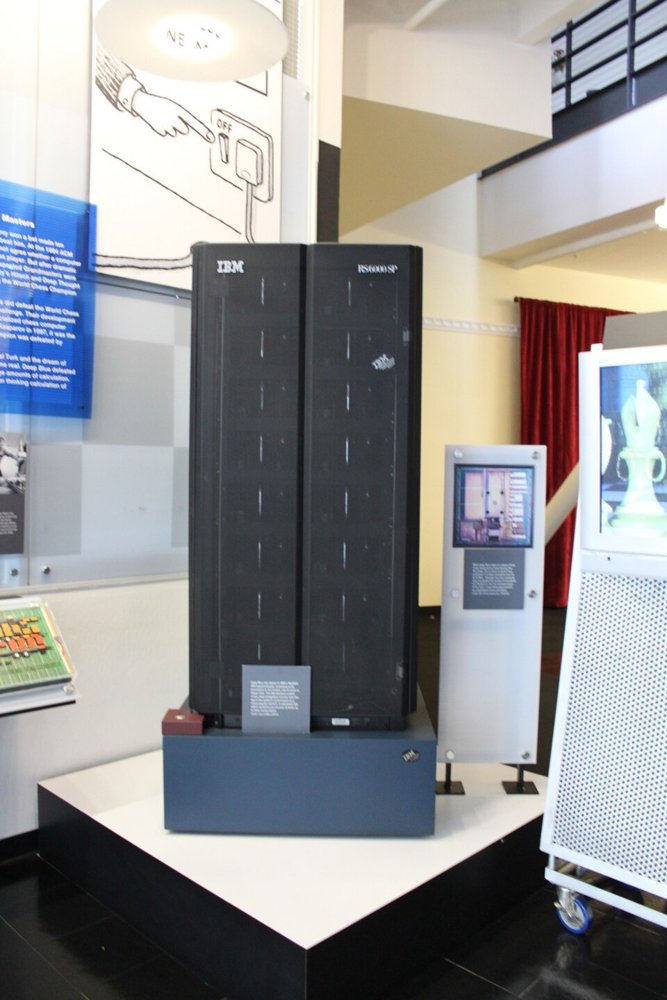
卡斯帕洛夫賽後一度質疑 IBM 有人為介入。多年後他轉而倡議「人機協作」:人加上機器,比單獨的人或機器都強。
1990–2000 年代:AI 換了一個名字
1990 到 2000 年代,研究者盡量少說「人工智慧」,改稱自己在做機器學習、資料探勘或模式辨識。換名字的背後,是想和過去過度樂觀的承諾保持距離,把焦點放在能具體解決的問題上。
這段時期的主流方法包括支援向量機(SVM)、決策樹、隨機森林與貝氏方法,共同特色是數學漂亮、理論完整,研究者能清楚說明模型為什麼有效。相較之下,神經網路被認為難以訓練,又容易過度擬合,也就是把訓練資料記得太死,遇到新資料反而表現變差,因此在主流會議上投稿常被拒。
雖然不再高調,AI 卻默默進入日常:垃圾郵件過濾、搜尋排名、推薦系統、信用卡盜刷偵測,背後都是這些技術。同一時間,網路普及帶來前所未有的大量資料,成為下一場革命的燃料。
2006:「深度學習」重新包裝
2006 年,辛頓與學生發表「深度信念網路」,替長期卡關的神經網路找到突破口。層數多的「深層」網路能力較強,卻一直很難訓練;他們提出逐層預訓練的方法,先一層一層分別訓練,再把整個網路組合起來,讓深層網路變得可以訓練。
辛頓也刻意為這個方向取了新名稱:「深度學習」(deep learning)。原因之一是「神經網路」這個詞在當時已經不太受歡迎。換一個名字,等於替被冷落的研究方向重新包裝,讓它有機會被重新看待。
在主流不看好的年代,研究能延續下去,資助扮演了關鍵角色。加拿大高等研究院(CIFAR)的支持,讓辛頓、楊立昆、班吉歐得以持續合作。後人稱他們為「加拿大黑手黨」,也稱為「深度學習三巨頭」。
2011:華生在益智節目獲勝
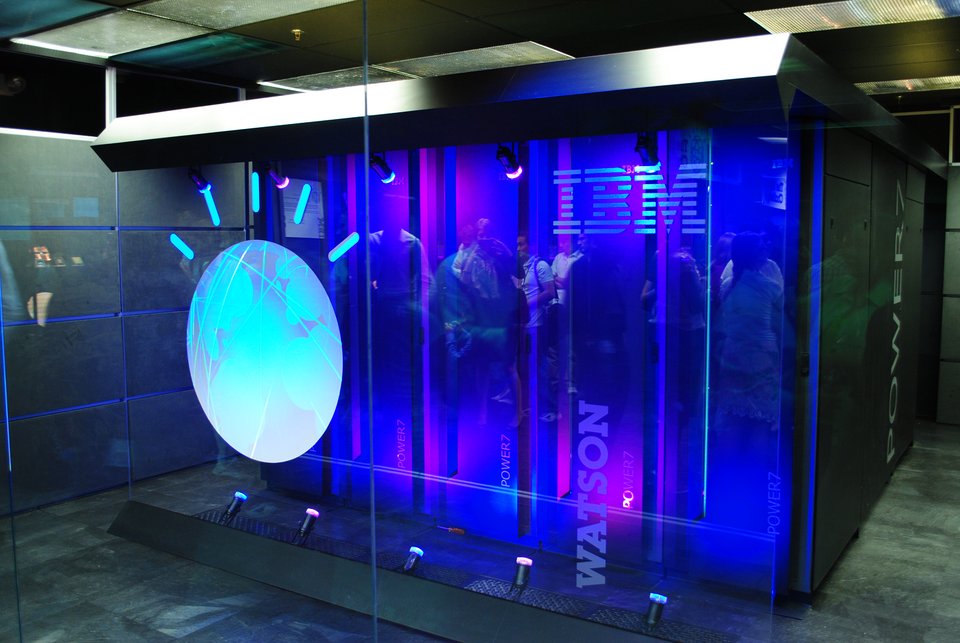
2011 年,IBM 的華生在美國益智節目《危險邊緣》擊敗兩位歷屆冠軍。這個節目的題目常帶有雙關與謎語,光是弄懂題目在問什麼就不容易;華生能理解這類英文題目並作答,展現了電腦處理人類語言的進展。
同一年,蘋果推出語音助理 Siri,一般人開始能用說話的方式和手機互動。AI 似乎一下子從研究室走進了日常生活。
不過,華生的故事還有後續。它後來轉向醫療應用,成效卻不如預期,成為「AI 過度包裝」的案例之一。在節目中表現亮眼,不代表能勝任複雜又攸關健康的真實工作,這是評估 AI 能力時值得記住的教訓。
2012 年之前:三樣東西各自就位
那年,三個人和兩張顯示卡
2012
AlexNet 的故事
在 2012 年以前,
他們走的那條路,
幾乎沒有人看好。
那條路叫做「神經網路」。
模仿人腦神經元的連結方式,讓電腦自己從大量例子裡學習。
這個想法早在幾十年前就有了,
但一直做不出像樣的成績。
到了 2000 年代,大部分研究者都覺得它是條死胡同。
有一個人不這麼想
在多數人轉身離開神經網路的年代,辛頓是少數始終沒有放手的人。他是英國人,1987 年搬到加拿大,在多倫多大學任教;從 1980 年代起,他的研究就一直圍繞著神經網路。
1986 年,他發表的反向傳播論文,讓多層神經網路的訓練方法廣為人知。反向傳播的做法是:先比較網路的輸出和正確答案差多少,再把這份誤差一層一層往回傳,調整每條連結的強弱,讓網路從錯誤中修正自己。要注意的是,這套數學方法更早就有人提出,1986 年那篇論文的貢獻,在於讓它普及開來。
然而接下來二十多年,這條路始終受到冷落。辛頓只能帶著一小群學生,繼續守著一門不受歡迎的學問。他手上有方法,那麼還缺什麼?答案有兩樣:資料與算力。
他缺的,其實只有兩樣東西。
夠多的資料。夠快的電腦。
資料:在美國的另一頭
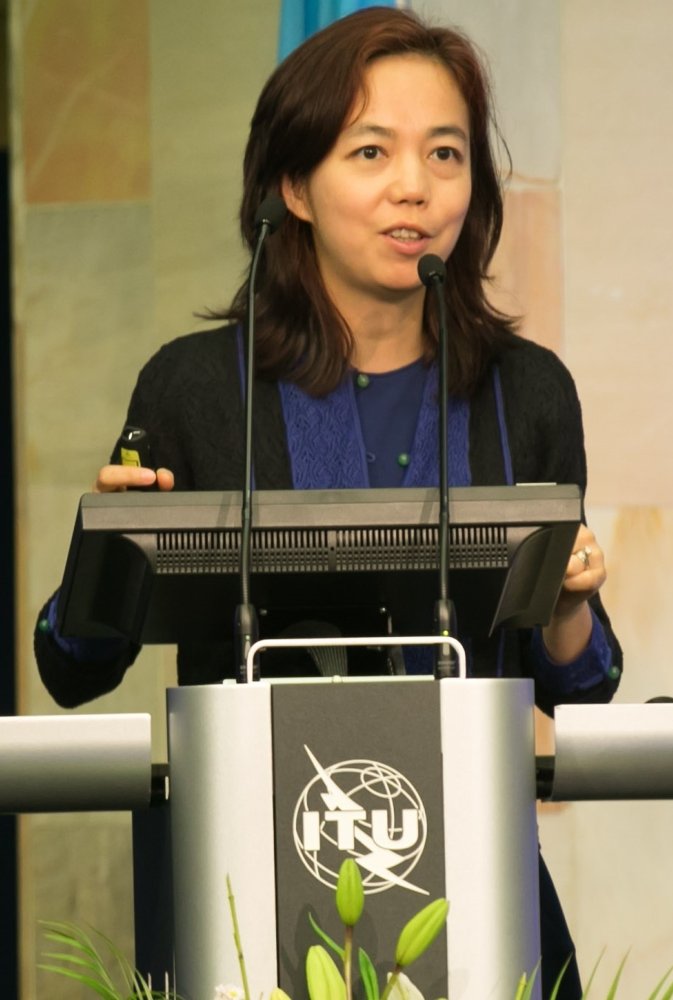
先說資料。在辛頓守著神經網路的同時,美國的李飛飛從另一個角度思考:電腦為什麼看不懂世界?她相信,問題在於電腦看過的東西太少。
想想一個小孩長大的過程:他看過成千上萬隻狗、成千上萬張桌子和人臉,才慢慢學會分辨。相較之下,當時電腦視覺研究使用的資料集,只有幾千到幾萬張圖,就像只讓小孩翻過一本薄薄的圖鑑,就要他認得整個世界。
於是她決定建立一份規模大得多的圖片資料庫,取名 ImageNet。這項工作 2007 年起在普林斯頓大學由她帶領團隊展開,2009 年她轉往史丹佛大學。有些流傳版本說她當時「在普林斯頓任教」,這只說對了起點:後來以 ImageNet 為基礎的比賽,是從史丹佛舉辦的。
ImageNet:讓全世界的人一起幫電腦「看圖」
標註工作透過亞馬遜 Mechanical Turk 完成——名字就來自第一章那台「藏著人的下棋機器」。
ImageNet 挑戰賽:看誰的程式認圖最準
有了資料,下一步是讓大家來比。2010 年起,ImageNet 每年舉辦一場挑戰賽,比賽資料約有 120 萬張訓練圖片,分屬 1,000 個類別。各隊要寫出程式,讓它自己判斷一張沒看過的圖片裡是什麼。
評分用的是「前五名錯誤率」(top-5 error rate):程式可以猜五個答案,只要正確答案落在這五個之中就算對,不在其中才算錯。這樣的設計比較寬容,能容納一張照片裡不只一樣東西、或類別彼此相近的情況。
成績卻進展緩慢。2010 年冠軍的錯誤率約 28%,2011 年約 26%,每年只進步一點點。李飛飛甚至開始懷疑:會不會是這份資料太難,現有的方法根本消化不了?
動手玩:你來當 AlexNet
每張圖,依你覺得的可能性寫下最多 5 個答案(第 1 格是你最有把握的)。答案要「夠精確」:寫「狗」不算,要寫出品種。全部作答完,會自動算出你的 top-1 與 top-5 錯誤率。
和機器比一比(top-5 錯誤率)
卡帕西親自標了一千多張測試圖,top-5 錯誤率約 5.1%;他說最難的就是狗的品種。2015 年,機器第一次在這個比賽上低於人類。
冷知識:ImageNet 的第 0 號類別
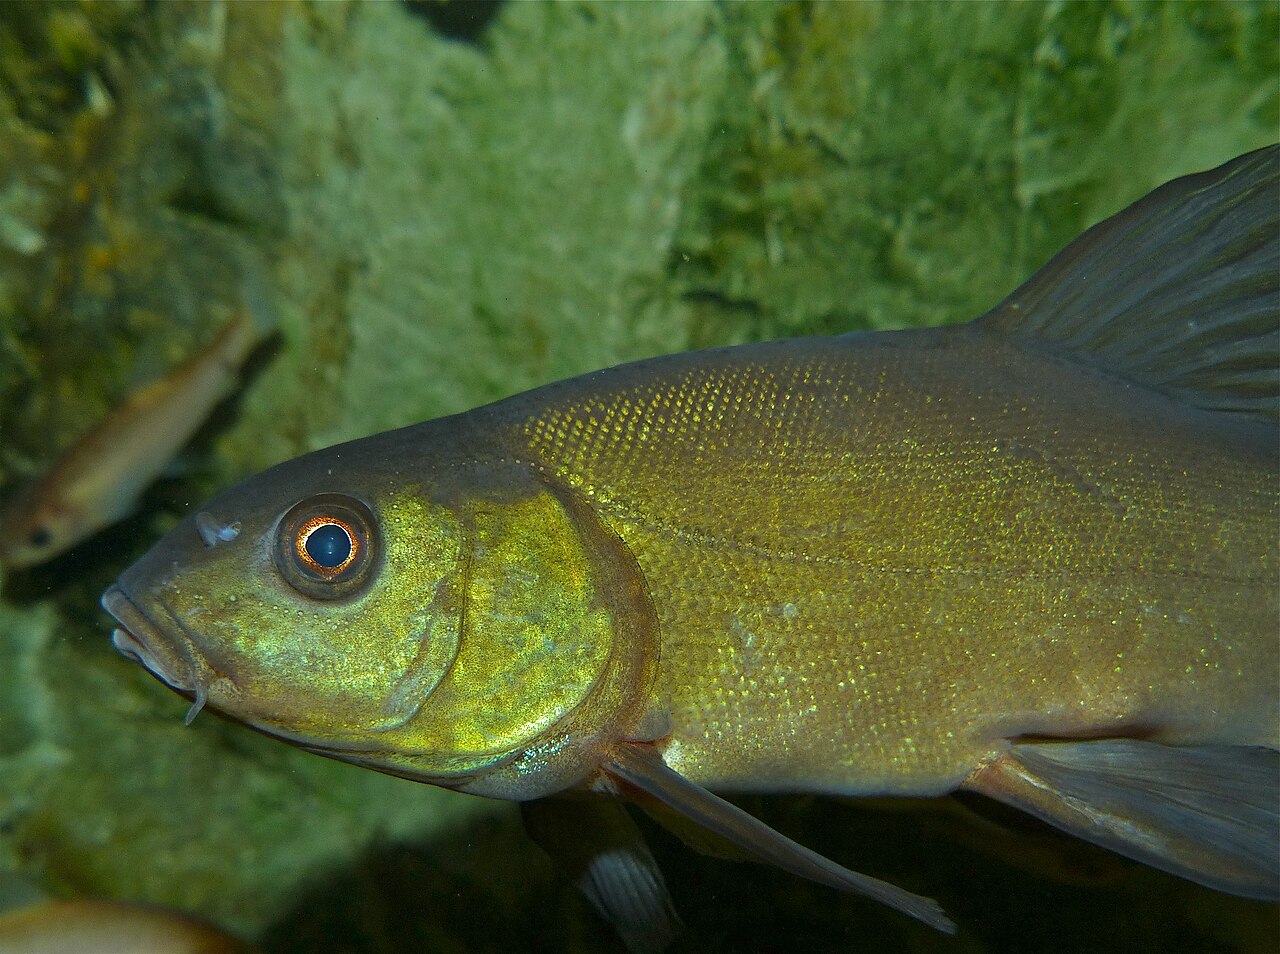
ImageNet 比賽的 1,000 個類別各有編號,第 0 號是一種歐洲淡水魚:丁鱥(tench)。這個不起眼的類別,後來成了說明「模型到底學到什麼」的好例子。
2019 年,Brendel 與 Bethge 在發表於 ICLR 的研究中,把模型的判斷拆開來看:當模型認為一張圖是丁鱥時,最看重畫面裡的哪些小區塊?結果排在前面的,常常是綠色背景上的人類手指。
原因出在照片本身。ImageNet 裡的丁鱥照片,大多是釣客把魚當戰利品捧在手上合照,手和魚幾乎總是一起出現。模型於是學到一條捷徑:看到「綠底上的手指」,就很可能是丁鱥。也因此,模型把圖片誤判成丁鱥時,常常只是因為畫面某處出現了這樣的手指。
這提醒我們,模型學到的是資料裡的規律,不一定是人以為的概念。資料是人拍的、人標的,人的習慣也會變成模型的捷徑;資料長什麼樣,模型就學成什麼樣。
她不知道的是,
多倫多有兩個研究生,
正盯著這份資料。
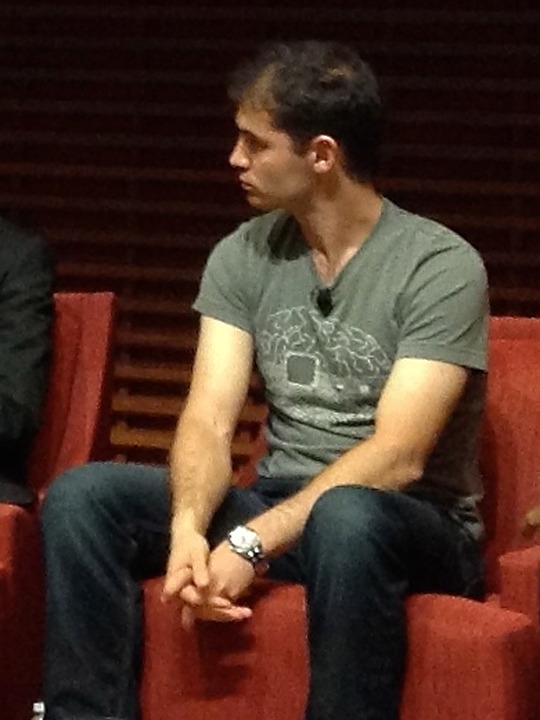
伊爾亞·蘇茨克維
Ilya Sutskever1986 年生
資料準備好了,但還需要有人相信,這麼大的資料正是神經網路需要的。辛頓的實驗室裡,就有這樣一個人。
伊爾亞·蘇茨克維 1986 年在蘇聯出生,五歲移民以色列,十六歲搬到加拿大。進入多倫多大學時,他直接從大三念起,後來成為辛頓的博士生。
他有一個非常堅定的信念:神經網路的表現,會隨著資料量一起變強。所以當許多人看著 ImageNet,覺得規模大到難以處理時,他看到的反而是機會:資料越多,神經網路越有發揮的空間。這種想法後來被稱為「規模化」(scaling)的直覺,也成為他日後在 OpenAI 推動 GPT 的核心想法。
但光有信念不夠,
還需要一個能把它做出來的人。
Alex Krizhevsky:真正把程式寫出來的人
光有信念還不夠,總得有人把程式真正寫出來,並讓它在有限的時間內跑完。這個人是艾力克斯·Krizhevsky。他在烏克蘭出生、加拿大長大,同樣是辛頓的博士生。
艾力克斯有一項特別的本事:很會壓榨顯示卡的效能,也就是把程式寫得貼合硬體的運作方式,讓每一個運算單元都不閒著。他早就自己寫好一套在顯示卡上跑卷積神經網路的程式,叫做 cuda-convnet。卷積神經網路是特別適合處理圖片的神經網路,會用許多小小的「濾鏡」掃過畫面,找出邊緣、紋理這類局部特徵,再逐層組合成更完整的形狀。
伊爾亞說服了艾力克斯,兩人決定拿 ImageNet 放手一搏,辛頓則是他們的指導教授。辛頓後來的說法很簡潔:Ilya 覺得應該做,Alex 把它做了出來。
沒有他的照片,但有他寫的程式
[conv1a]
type=conv
inputs=data
filters=32
stride=4
filterSize=11
gpu=0

[conv1b]
type=conv
inputs=data
filters=32
stride=4
filterSize=11
gpu=1
……
[logprob]
coeff=1
topk=5
摘自 layers/layers-120.cfg 與 layer-params-120-2012-full.cfg(computerhistory/AlexNet-Source-Code)
艾力克斯很少公開露面,維基共享資源上沒有任何可自由使用的照片。不過,他留下了另一種更直接的紀錄:程式本身。2025 年,電腦歷史博物館把 AlexNet 的原始程式碼公開在 GitHub,採用 BSD 開源授權。
圖中是 AlexNet 的網路設定檔。其中寫著 conv1a 放在 gpu=0、conv1b 放在 gpu=1:第一個卷積層被分成 a、b 兩份,分別交給編號 0 和 1 的兩張顯示卡。換句話說,整個網路真的被拆成兩半,各放一張卡。設定檔最後的 topk=5,對應的就是前面提到的「前五名錯誤率」。
整個 layers 資料夾裡,共有 161 個編號的實驗設定檔。每一個都代表一次調整後的嘗試,是將近一年反覆修改的實物證據。
他的實驗筆記:訓練 AlexNet 的那幾週
# this is like #120 (so uses def file #120)
#   but trained on lsvrc-2012 (full)
# /storage/tmp/ConvNet__2012-07-26_04.06.44
# epoch 23: set epsw to 0.001 from 0.01
# epoch 38: moved to guppy9
# /nobackup/kriz/tmp/ConvNet__2012-07-26_04.06.44
# epoch 49: set epsw to 0.0001 from 0.001
# epoch 66: set epsw to 0.00001 from 0.0001 on conv1,conv2
#           set color noise to 0 from 0.1
# epoch 73: set epsw to 0 from 0.00001 on conv1,conv2
# epoch 87: set epsw to 0.00001 from 0.0001
# epoch 94: killed
摘自 layers/layer-params-120-2012-full.cfg 檔尾註解(原文照錄)
在設定檔的最後,艾力克斯留下了手寫的訓練紀錄。這不是事後的回憶,而是當時工作留下的第一手史料。
紀錄裡有一個時間戳記:2012-07-26 凌晨 4 點 06 分,這次訓練開始,使用的是 2012 年完整的比賽資料(lsvrc-2012 full)。裡頭的 epsw 是學習率,也就是網路每次根據錯誤修正自己時,步伐要跨多大。步伐太大容易修過頭,太小又學得太慢;他每隔一段時間就手動把學習率調小十倍,讓網路在後期「學得更細」。
紀錄中還寫著「epoch 38: moved to guppy9」。一個 epoch 是把全部訓練資料完整看過一輪,這行表示訓練到第 38 輪時,換到另一台名叫 guppy9 的機器繼續跑;檔案路徑裡的 kriz 則是他的帳號。最後一行「epoch 94: killed」,表示跑完 94 輪後停止,這時距離 9 月底的比賽截止只剩兩個月。
需要說明的是,這份設定檔屬於 #120 系列的一次完整訓練,不一定就是最後提交比賽的那個模型。
說到這裡,
要先講講那兩張顯示卡。
顯示卡:原本是為了電玩而生
再說算力。要從上百萬張圖片中學習,神經網路得做極大量的計算,而解答來自一個意想不到的地方:電玩。
顯示卡原本負責把遊戲畫面快速畫出來。畫面的每一個瞬間,都有幾十萬、幾百萬個像素要決定顏色,每個像素的計算並不複雜,但數量極多。因此顯示卡的特長是同時處理大量簡單的計算,也就是平行運算;相對地,一般電腦的中央處理器(CPU)擅長的是一步步處理較複雜的工作。
訓練神經網路剛好也是這種工作。它的核心是大量的矩陣乘法與加法:成千上萬個數字各自相乘再相加,彼此之間大多互不干擾,可以同時進行。兩件原本毫不相關的事,就這樣接上了。
黃仁勳
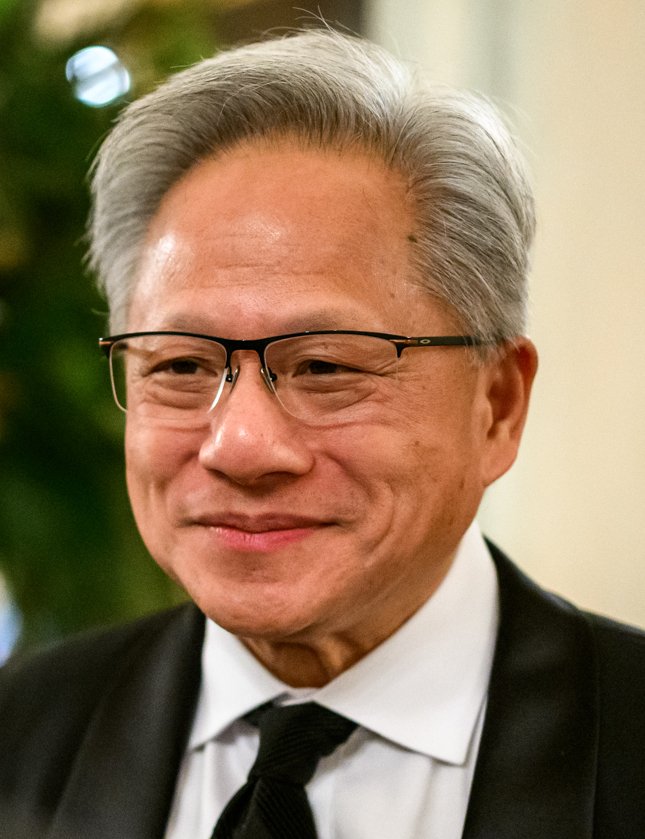
Jensen Huang1963 年生於臺灣臺南
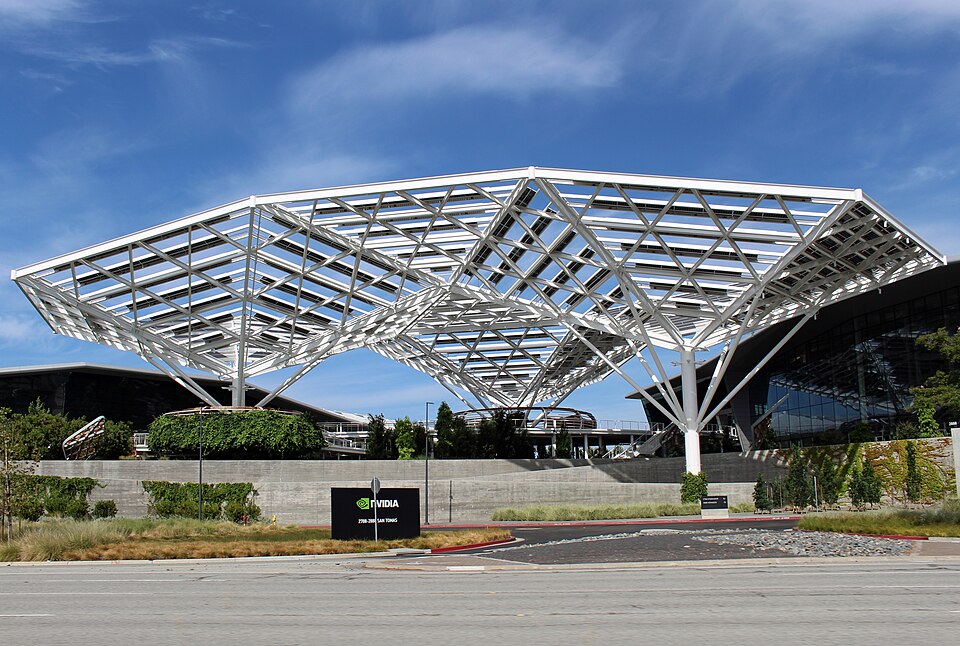
要讓顯示卡做遊戲以外的事,還需要一座橋,搭橋的是黃仁勳。他 1963 年生於臺灣臺南,九歲赴美,1993 年共同創辦 NVIDIA 並擔任執行長。
2006 年,NVIDIA 推出 CUDA。這是一套程式設計平台,讓工程師可以直接拿顯示卡做遊戲以外的計算,例如科學運算或資料處理。艾力克斯的 cuda-convnet,名字裡的 cuda 指的就是它。
不過當時市場並不買單,投資人質疑這筆研發支出是否值得。2008 年金融海嘯期間,NVIDIA 股價從高點跌掉七成以上;對照股價紀錄,從 2007 年高點到 2008 年底,跌幅約達八成。這項不被看好的投資,幾年後卻成了訓練神經網路的關鍵工具。
我剛告訴一千個機器學習研究者,他們應該去買 NVIDIA 的顯示卡。可以送我一張免費的嗎?
— 辛頓寫給 NVIDIA 的信(2009 年前後)
NVIDIA 拒絕了。
後來,團隊還是自己買了。
GeForce GTX 580
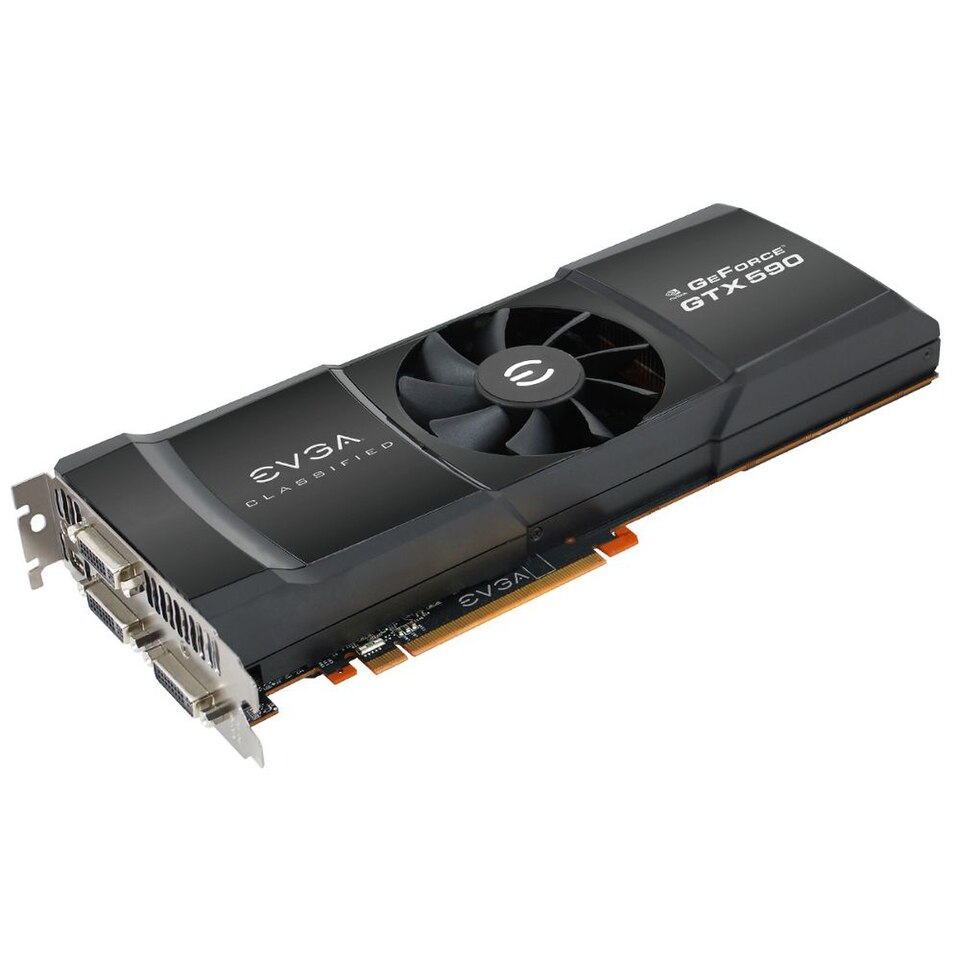
艾力克斯用的是兩張 NVIDIA GeForce GTX 580 顯示卡。每張卡有 512 個 CUDA 運算核心、3GB 記憶體;數百個核心可以同時計算,正好符合神經網路的需求。
問題出在記憶體。訓練時,網路的參數與中間計算結果都得放在顯示卡的記憶體裡,而 AlexNet 太大,一張卡裝不下。解決辦法是把網路拆成兩半,分別放在兩張卡上同時訓練,這也就是設定檔裡 gpu=0 和 gpu=1 的由來。
這張卡還有一層臺灣連結:它的 GF110 晶片,是由台積電以 40 奈米製程生產的。至於速度,網路上流傳的版本說它比 CPU「快了好幾百倍」,但論文中沒有這個數字,也找不到出處,屬於誇大;一般估計是快了數十倍。即使如此,這樣的差距已足以讓反覆訓練、反覆修改變得可行。
於是,那兩張卡
被裝進了艾力克斯爸媽家的臥室。
接下來將近一年
資料、算力、人都到齊了,成功卻沒有馬上到來。接下來將近一年,他們做的事情相當單調:調整參數、重新訓練,一次又一次。改程式,跑,失敗,調參數,再跑,再失敗,再改。
這段過程和一般對「突破」的想像不同。AlexNet 不是某天晚上突然的靈光一閃,而是大量重複嘗試累積出來的成果,前面那 161 個實驗設定檔就是證據。「將近一年」這個說法,也與電腦歷史博物館的描述一致。
最後定案的版本,在兩張顯示卡上跑了五、六天,這個數字出自 AlexNet 的原始論文。這個程式後來被叫做 AlexNet,取自艾力克斯的名字。
AlexNet 做對了哪些事?
AlexNet 常被說成一項突破,但拆開來看,它用到的技術沒有一個是全新的發明;真正的關鍵,是把這些做法組合在一起,並且放大規模。
夠大:網路有 8 層、約 6,000 萬個參數、65 萬個神經元。參數是網路裡可以調整的數字,相當於每條連結的強弱;參數越多,網路能捕捉的規律就越複雜,在當時這是巨大的網路。夠多資料:大網路需要大量例子才學得好,ImageNet 正好提供了 120 萬張標註好的圖片。
ReLU:激發函數決定一個神經元收到訊號後要輸出多少。AlexNet 改用更簡單的 ReLU,規則幾乎只有「負的變成零、正的照原樣輸出」,計算省力,訓練速度快了好幾倍。Dropout:訓練時隨機「關掉」一部分神經元,逼網路不能只依賴少數連結,避免它死背訓練資料的答案,遇到新圖片卻認不出來。
資料擴增:把同一張圖片翻轉、裁切、調整顏色,對網路來說就像多了幾張新照片,等於憑空變出更多訓練資料。雙 GPU:把網路拆在兩張顯示卡上平行訓練,解決單張卡記憶體不夠的問題。
夠大
8 層、約 6,000 萬個參數、65 萬個神經元,在當時是巨大的網路。
ReLU
改用更簡單的激發函數,訓練速度快了好幾倍。
Dropout
訓練時隨機「關掉」部分神經元,避免死背答案。
資料擴增
把圖片翻轉、裁切、調色,憑空變出更多訓練資料。
雙 GPU
把網路拆在兩張卡上平行訓練。
夠多資料
120 萬張標註好的 ImageNet 圖片。
「夠大」有多大?拖動滑桿看看
方塊面積=參數數量(網路裡要學習、調整的數字)。每往右一格,加入一個更大的模型,前面的方塊就會縮小。
2012 年 9 月 30 日。
ImageNet 比賽結果出爐。
一個不像話的差距
在一個每年只能進步一兩個百分點的比賽裡,這個差距大得不像話。
歷年進步曲線:ImageNet 冠軍的前五名錯誤率
2010→2011 只進步 2.4 個百分點;2012 年 AlexNet 一口氣降了 10.5 個百分點。之後每年冠軍都是深度學習,2015 年首次低於人類。
2012 年 10 月,義大利佛羅倫斯
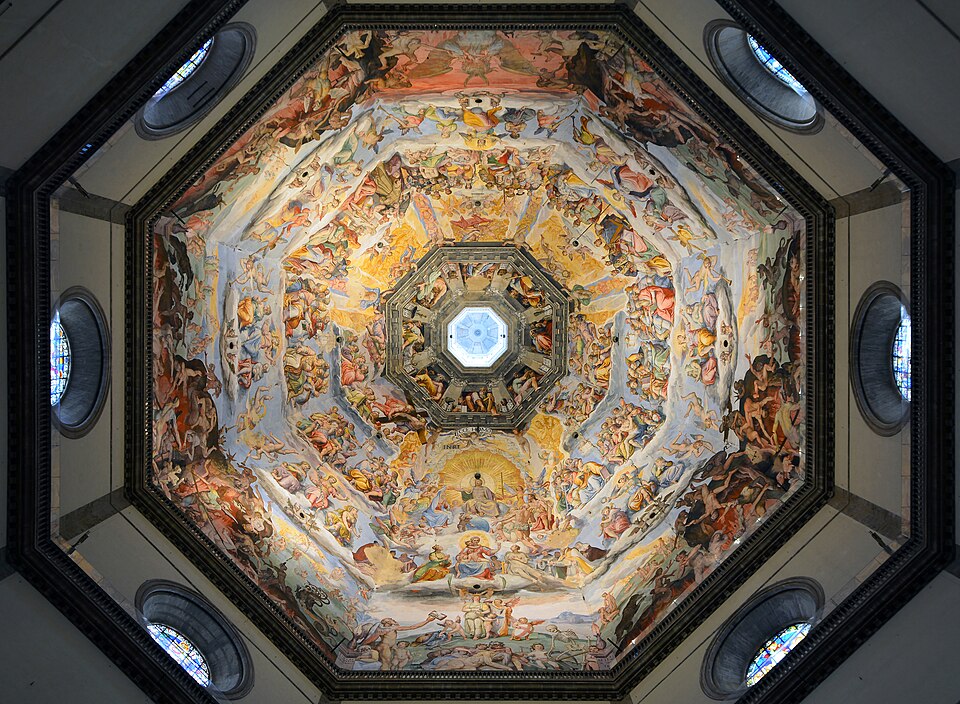
2012 年 10 月,比賽結果在義大利佛羅倫斯舉行的歐洲電腦視覺大會(ECCV)上,透過其中的 ImageNet 研討會正式發表。
李飛飛那時剛生完小孩,仍從加州飛了過去。這段細節出自她 2023 年出版的回憶錄《The Worlds I See》,屬於本人自述。
艾力克斯上台報告時,會場擠得連站的位置都沒有。台下坐著楊立昆,以及許多後來成為 AI 重量級人物的研究者。一個被冷落了二十多年的研究方向,在這一刻成了全場注目的焦點。
這是電腦視覺史上毫無疑問的轉捩點。這就是證據。
— 楊立昆(Yann LeCun),2012 年佛羅倫斯
現代 AI 的三個基本元素,第一次湊在一起了:神經網路、大數據,以及 GPU 運算。
— 李飛飛回顧 AlexNet(電腦歷史博物館)
三個被冷落的東西
在同一個時間點撞在一起,火就這樣點起來了。
接下來發生的事,
快得連他們自己都沒料到。
DNNresearch:一間只有三個人的公司
比賽之後,辛頓和兩個學生成立了一間小公司,叫 DNNresearch。這間公司沒有產品、沒有業務團隊,也沒有員工。
一般公司的價值,來自它賣的東西、它的客戶或營收;DNNresearch 這些都沒有,真正的資產只有三個人的腦袋,也就是他們訓練大型神經網路的知識與經驗。成立公司,讓這份看不見的能力有了一個可以談價格的形式。
而科技巨頭都想要。AlexNet 讓大家看見神經網路的潛力,懂得把它做出來的,正是這三個人。
2012 年 12 月,太浩湖畔的賭場飯店
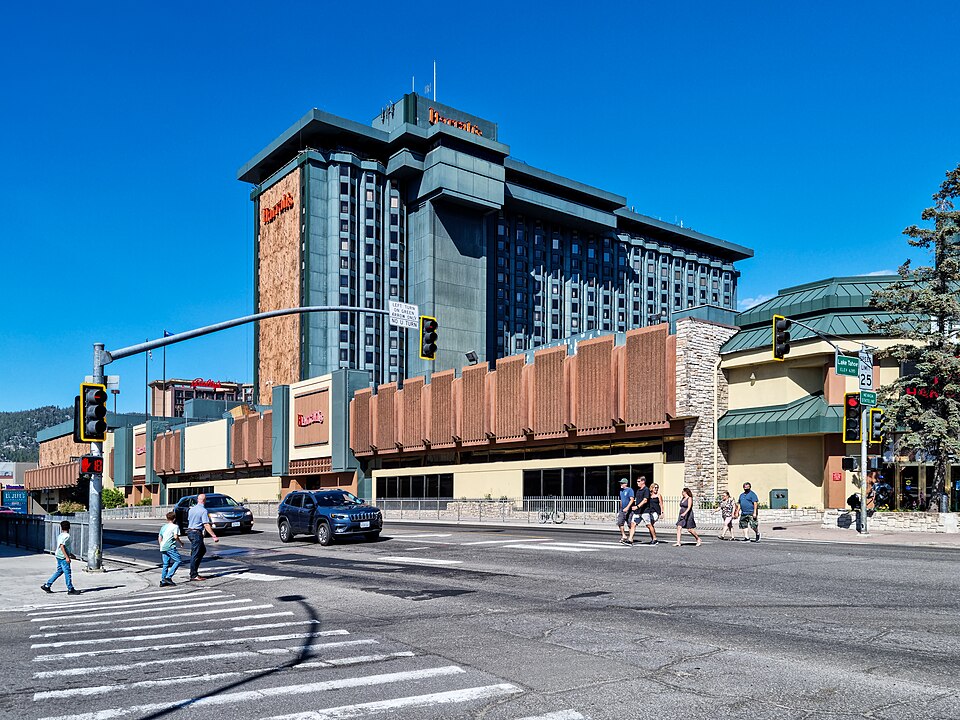
2012 年 12 月,神經資訊處理系統大會(NIPS,今日改稱 NeurIPS)在太浩湖畔的賭場飯店舉行。辛頓就在 Harrah's 飯店的 731 號房,為 DNNresearch 辦了一場競標。
辛頓背部有舊傷,多年無法坐下;他來開會是搭火車橫越北美,因為坐不了飛機。據記載,競標那幾天,他把筆電擺在一個倒過來的垃圾桶上,從頭到尾站著看信。
這些生動的細節,出自 Cade Metz 的書《Genius Makers》第一章,後來被多家媒體轉述。雖然流傳很廣,但讀的時候要知道,它們屬於單一來源:各家報導的源頭,基本上都是這本書。
一場用 Gmail 進行的競標
參與出價的有四家:百度、Google、微軟、DeepMind。規則是:每當有人出價,其他家有一小時可以決定是否加碼,而每次至少要加 100 萬美元。這樣的設計讓價格只會往上走,每一家也都得在短時間內判斷值不值得繼續跟。
諷刺的是,出價用的是 Gmail,而 Google 本身就是競標者之一。換句話說,競爭對手的每一封出價信,都經過其中一位競標者的服務。
過程中,DeepMind 很早就退出;微軟退出又回來,回來又退出。價格從 1,500 萬美元起,一路往上喊。
最後停在
據報導,辛頓在這個價位主動喊停,選了 Google——他認為 Google 能給他繼續做研究的最好環境。
2013 年 3 月
結果在 2013 年 3 月揭曉:Google 宣布收購 DNNresearch。兩個學生搬到 Google 在加州的總部,辛頓則一邊在 Google 工作,一邊繼續留在多倫多大學教書。
那場競標,後來被很多人視為 AI 人才爭奪戰的起點。科技公司競相出價,買的不是產品或客戶,而是幾個人和他們的能力,這顯示研究者本身已成為最搶手的資源。
還有一段後話:在競標中很早退出的 DeepMind,隔年(2014)自己被 Google 收購。當年四家出價者中的兩家,最後都歸到了同一間公司底下。
十幾年過去,
三個人走上了很不一樣的路。
辛頓:從守火人到警鐘
Geoffrey Hinton2013 → 今
收購之後,辛頓在 Google 待了十年。這段期間,曾被冷落的神經網路成了 AI 研究的主流,學術界也給了正式的肯定:2018 年,他與楊立昆、班吉歐共同獲得圖靈獎,這是電腦科學領域最具代表性的獎項之一。
2023 年 5 月,他離開 Google,理由是想更自由地公開談論 AI 可能帶來的風險。一位花了大半輩子推動神經網路的人,轉而提醒社會留意這項技術的風險,這個轉變本身就值得思考。
2024 年,他與霍普菲爾德共同獲得諾貝爾物理學獎。從守著一門不受歡迎的學問,到站上諾貝爾獎的舞台,辛頓的經歷幾乎貫穿了神經網路的起落。
Ilya 覺得我們應該做,Alex 把它做了出來,然後我拿到了諾貝爾獎。
— 辛頓談 AlexNet
伊爾亞:從 Google 到 OpenAI
Ilya Sutskever2013 → 今
伊爾亞在 Google 待了兩年多,參與了序列到序列(seq2seq)等重要研究。seq2seq 是讓神經網路讀進一串文字、再輸出另一串文字的方法,例如把一句英文轉成一句法文;這和後來的語言模型處理的是同一類問題。
2015 年,他與奧特曼、馬斯克等人共同創辦 OpenAI,擔任首席科學家,主導 GPT 系列研究,也參與打造 ChatGPT。他在 AlexNet 時期就抱持的信念:資料越多、模型越大,表現就越強,一路延續到了 GPT。
2024 年,他離開 OpenAI,另外創辦專注 AI 安全的公司 Safe Superintelligence(SSI)。
Alex Krizhevsky:三個人裡最低調的一個
三個人裡,真正把程式寫出來的艾力克斯,反而最少出現在媒體上。他在 2017 年離開 Google。
不過,AlexNet 原始碼能重見天日,他是關鍵人物。2020 年,美國電腦歷史博物館(CHM)的策展人先找上他,希望公開 AlexNet 的原始碼。由他牽線,博物館聯絡上當時還在 Google 的辛頓,接著與 Google 協商,一談就是整整五年。這段經過,由策展人 Hansen Hsu 在博物館官方部落格中說明。
2025 年 3 月,AlexNet 原始程式碼終於在 GitHub 公開,前面看到的網路設定檔與訓練紀錄,就是從這批程式碼中來的。
那兩張顯示卡背後的公司
回頭看那兩張顯示卡背後的公司,變化相當驚人。2012 年,NVIDIA 主要被認為是一家遊戲顯示卡公司,市值不到 100 億美元,年底約 76 億美元。當時辛頓曾寫信向它要免費的顯示卡,結果被拒絕。
到了 2026 年,全世界的 AI 研究者與企業都在買它的 GPU。根據 Forbes 2026 年 5 月 13 日的報導,NVIDIA 市值衝上 5.5 兆美元,是史上第一家達到這個規模的公司。
兩個時間點相比,市值大約成長了 720 倍:若以 100 億美元計,至少是 550 倍;以 2012 年底約 76 億美元計,約為 720 倍。只是這一次,沒有人再開口要免費的了。
2012 年的 NVIDIA
- 主要被認為是一家遊戲顯示卡公司
- 市值不到 100 億美元(年底約 76 億)
- 辛頓寫信要免費的顯示卡,被拒絕
2026 年的 NVIDIA
- 全世界的 AI 研究者與企業都在買它的 GPU
- 2026 年 5 月市值衝上 5.5 兆美元,史上第一家
- 約 720 倍:以 100 億計至少 550 倍;以 2012 年底約 76 億計約 720 倍
NVIDIA 年 K 線:從 AlexNet 到 5.5 兆
上漲(收盤高於開盤)下跌 · 每根 K 棒=一年的開、高、低、收
2012 年 AlexNet 那一週,股價(還原分割)約 0.33 美元;2026 年 5 月 13 日市值突破 5.5 兆那天收在 225.83 美元,約 680 倍。切到對數刻度,可以看出 2016 年 AlphaGo 那年單年漲了 3 倍多,而 2022 年 ChatGPT 上線前其實先大跌了一半。將滑鼠移到 K 棒上可看當年的開、高、低、收。
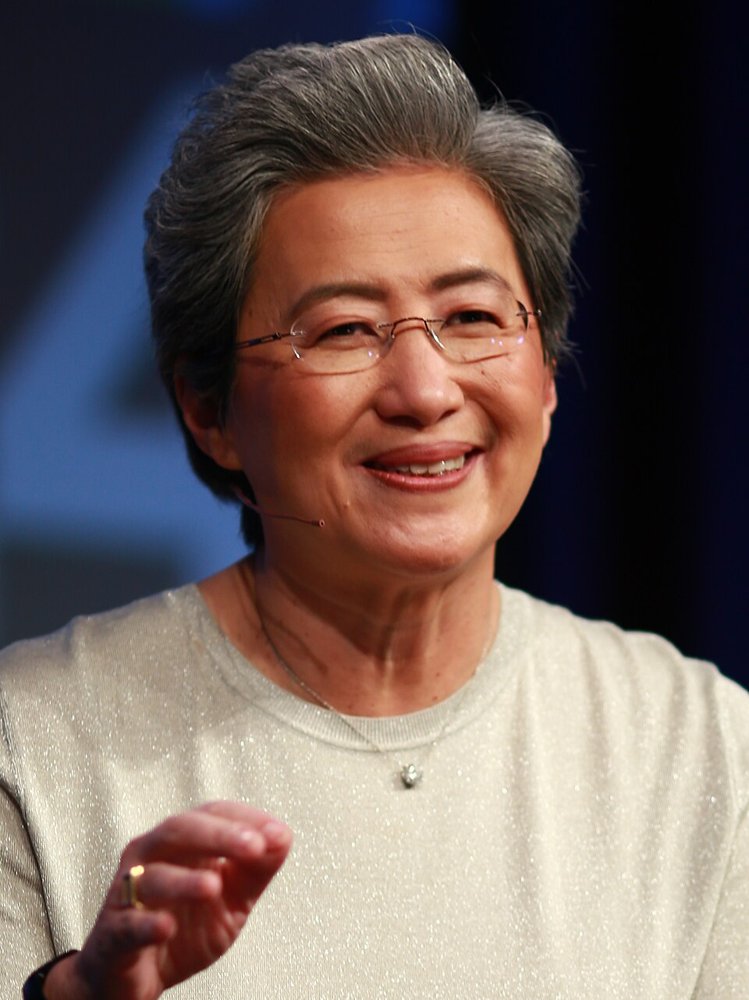
蘇姿丰
Lisa Su1969 年生於臺灣臺南
故事的尾聲,又回到了臺南與李飛飛。蘇姿丰 1969 年生於臺灣臺南,現任 AMD 董事長兼執行長;AMD 是 NVIDIA 在 AI 晶片上的主要對手。她和黃仁勳都出生於臺南,常見報導指出兩人有遠房親戚關係。
2026 年 9 月 28 日,AMD 宣布以約 82 億美元收購 World Labs,採全股票交易,也就是不付現金,而是以 AMD 的股票支付。World Labs 由李飛飛共同創辦,研究讓 AI 理解並生成立體世界的「空間智慧」;NVIDIA 與 AMD 都曾是它的投資人。這項消息見於 AMD 官方新聞稿,以及 TechCrunch、Fortune 當天的報導。
要注意,這筆交易目前是「已宣布、尚未完成」,預計 2026 年底前完成,仍待主管機關核准。當年替電腦準備大量圖片的李飛飛,如今研究的是讓 AI 看懂立體空間,而兩家顯示卡公司都曾投資她的方向。
十四年前,讓 AI 起飛的,
是 ImageNet 加上 NVIDIA 的顯示卡。
十四年後,ImageNet 的創辦人,
將出任 NVIDIA 對手 AMD 的首席科學家。
改變世界的那三樣東西,
在當時都不起眼。
一個被冷落了幾十年的理論,一份頭兩年沒人能好好消化的資料庫,
還有兩張本來是拿來打電動的顯示卡。
它們都在等一個房間,把它們湊在一起。
那個房間,剛好是
一個研究生在爸媽家的臥室。
這個故事裡,你覺得誰最關鍵?
辛頓的堅持、李飛飛的資料、伊爾亞的信念、艾力克斯的實作,還是黃仁勳的 CUDA?
沒有標準答案。試著想像:少了其中一個人,AI 史會延後幾年?
這個故事,我們是怎麼查核的?
前面的故事,改寫自一篇在網路上廣為流傳的科技文章〈那年,三個人和兩張顯示卡〉。它讀起來非常可信:有人名、有日期、有精確的數字,還有當事人的引語。但讀起來可信,和真的正確,是兩回事。
因此我們逐句回到原始來源查核,包括電腦歷史博物館的資料、AlexNet 論文、當事人的回憶錄與新聞報導。結果是大部分屬實,但有一處誇大(顯示卡「快了好幾百倍」)、一處找不到出處、兩處需要補充,還有幾段只有單一來源。
故事各段標示的「屬實」「單一來源」「誇大」,都來自這次逐句查核,詳細結果列在後續的查核表中。這套做法不只適用於歷史故事:之後檢查 AI 的回答,用的也是同一套方法,也就是找到原始來源、逐句確認。
故事查核總表(一):人物與背景
故事查核總表(二):GPU 與比賽
故事查核總表(三):競標與後續
請你用 ChatGPT 或 Uedu 把這段故事改寫成「給高中生的三分鐘版本」,
然後檢查:AI 有沒有加入故事裡沒有的「事實」?
這是練習「AI 幻覺查核」的好機會:把 AI 改寫版和本頁的查核表逐條對照。
深度學習大爆發
2013 – 2017
AlexNet 之後,十年內發生的事
AlexNet 之後,研究方向一夕翻轉
AlexNet 在 ImageNet 影像辨識競賽中的勝利,讓研究者親眼看到深度學習的實力。深度學習指的是用多層神經網路,直接從大量資料中學出辨識所需的特徵,不必再由研究者人工設計。從 2013 年起,ImageNet 的參賽隊伍幾乎全部改用這個方法。
產業界的反應同樣迅速。Google、Facebook、微軟、百度紛紛成立深度學習實驗室,以高薪延攬研究者。楊立昆在 2013 年加入 Facebook,成立 FAIR 實驗室;吳恩達則在 2014 年加入百度擔任首席科學家。頂尖研究者走進企業,意味著研究可以結合企業手上的大量資料與運算資源。
影像只是開端。語音辨識、翻譯、推薦系統陸續換成神經網路,深度學習從一場競賽的贏家,逐漸變成多數 AI 應用的共同基礎。
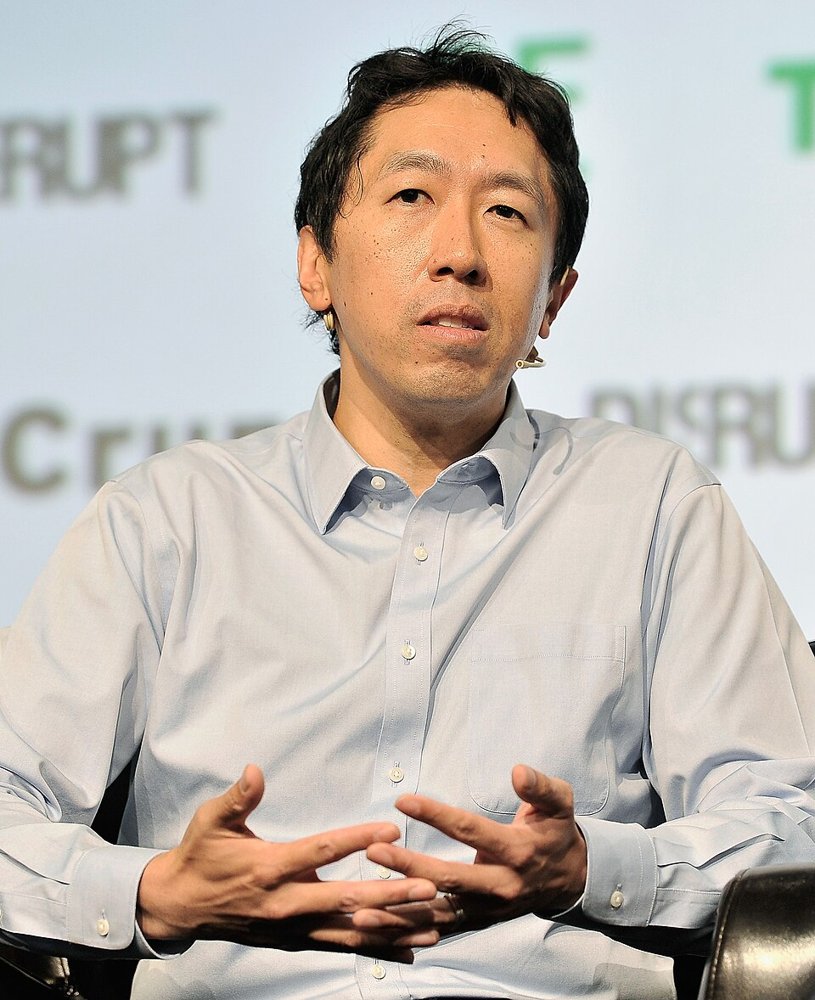
吳恩達
Andrew Ng1976 年生
吳恩達是史丹佛大學教授,2011 年共同創立 Google Brain。2012 年 6 月,Google Brain 動用 1.6 萬個 CPU 核心訓練神經網路,讓它從 YouTube 影片中自己學會辨認「貓」。這顯示只要資料與算力足夠,網路能自行歸納出有意義的概念。
同年秋天,AlexNet 只用 2 張 GPU 就贏下 ImageNet。兩相對照,差距一目了然。CPU 是電腦的通用處理器,擅長依序處理複雜指令;GPU 原本為繪製畫面而設計,擁有大量能同時計算的小核心,正好適合神經網路裡大量重複的簡單運算。從上萬個 CPU 核心到 2 張 GPU,說明了 GPU 為何成為深度學習的關鍵硬體。
同樣在 2012 年,吳恩達共同創辦線上課程平台 Coursera,他的機器學習課程影響了數百萬學習者,讓這門學問走出少數大學的教室。
2013–2017 關鍵里程碑
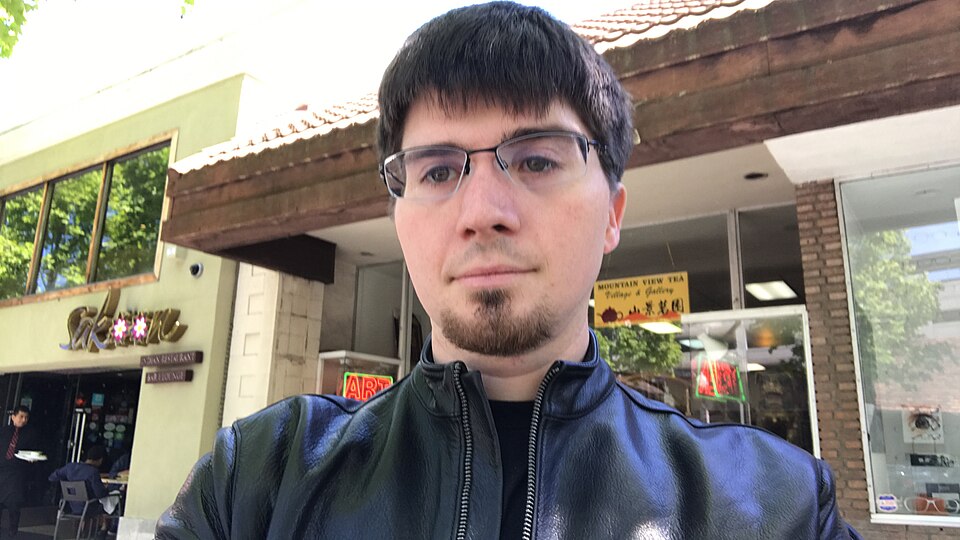
伊恩·古德費洛
Ian Goodfellow1980 年代生
2014 年,還是班吉歐博士生的古德費洛提出「生成對抗網路」(GAN)。據他自述,這個構想來自一次在酒吧與同學的討論,他當晚回家就把程式寫了出來。
GAN 的設計是讓兩個網路互相對抗。一個負責「造假」,例如憑空畫出一張人臉;另一個負責「抓假」,判斷眼前的圖片是真照片還是假造的。抓假的一方每找到破綻,造假的一方就據此改進;造假者進步了,抓假者也得更敏銳。就像偽鈔製造者和驗鈔員互相較勁,雙方一起變強,最後造假者能生成以假亂真的人臉。
這讓 GAN 成為「生成式 AI」的重要源頭之一:機器不只會辨認,也開始能創造新的內容。同一項技術也帶來深偽(deepfake)的問題,逼真的偽造影像可能被用來欺騙或傷害他人。
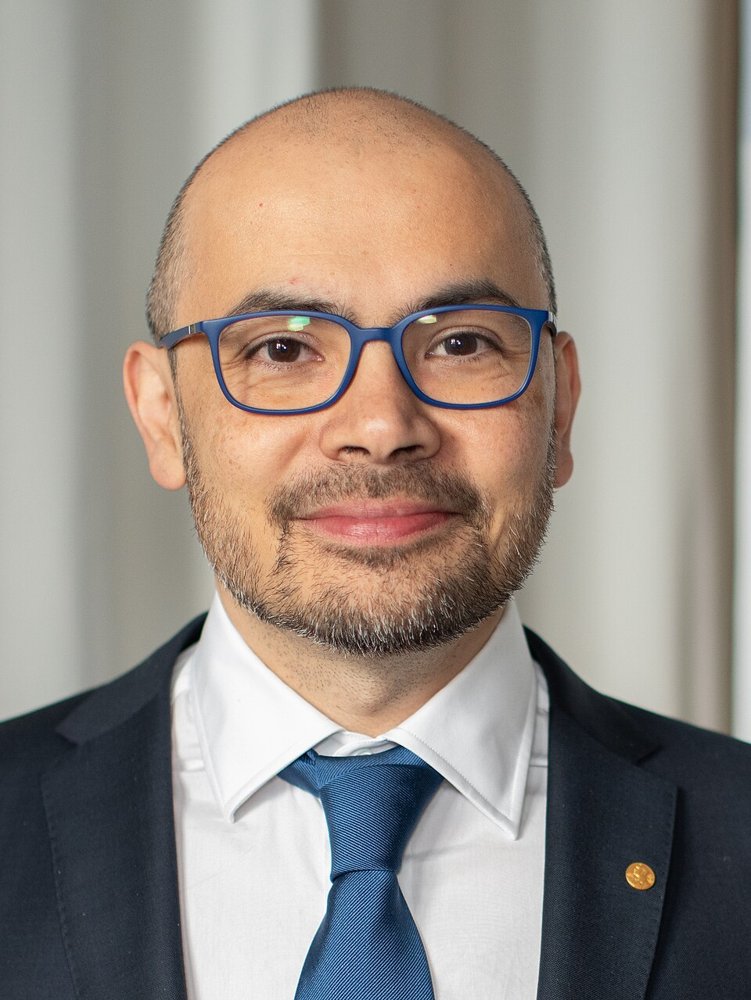
德米斯·哈薩比斯
Demis Hassabis1976 年生
哈薩比斯的經歷橫跨好幾個領域:他是西洋棋神童,當過電玩設計師,又取得認知神經科學博士。策略遊戲、虛擬世界與大腦研究,這些背景都和「智慧是什麼」這個問題有關,也匯集到他後來的 AI 事業裡。
2010 年,他共同創辦 DeepMind,目標是「解決智慧,再用它解決其他所有問題」。2012 年 DNNresearch 被各方競標時,DeepMind 很早就退出;2014 年,DeepMind 被 Google 收購,得到更充足的資源。
他帶領團隊做出 AlphaGo 與 AlphaFold。前者在圍棋上擊敗人類頂尖棋士,後者則把 AI 用在預測蛋白質結構這類科學問題上。2024 年,他因 AlphaFold 與 John Jumper 共同獲得諾貝爾化學獎,顯示 AI 的用途已從遊戲延伸到基礎科學。
2016:AlphaGo 對李世乭
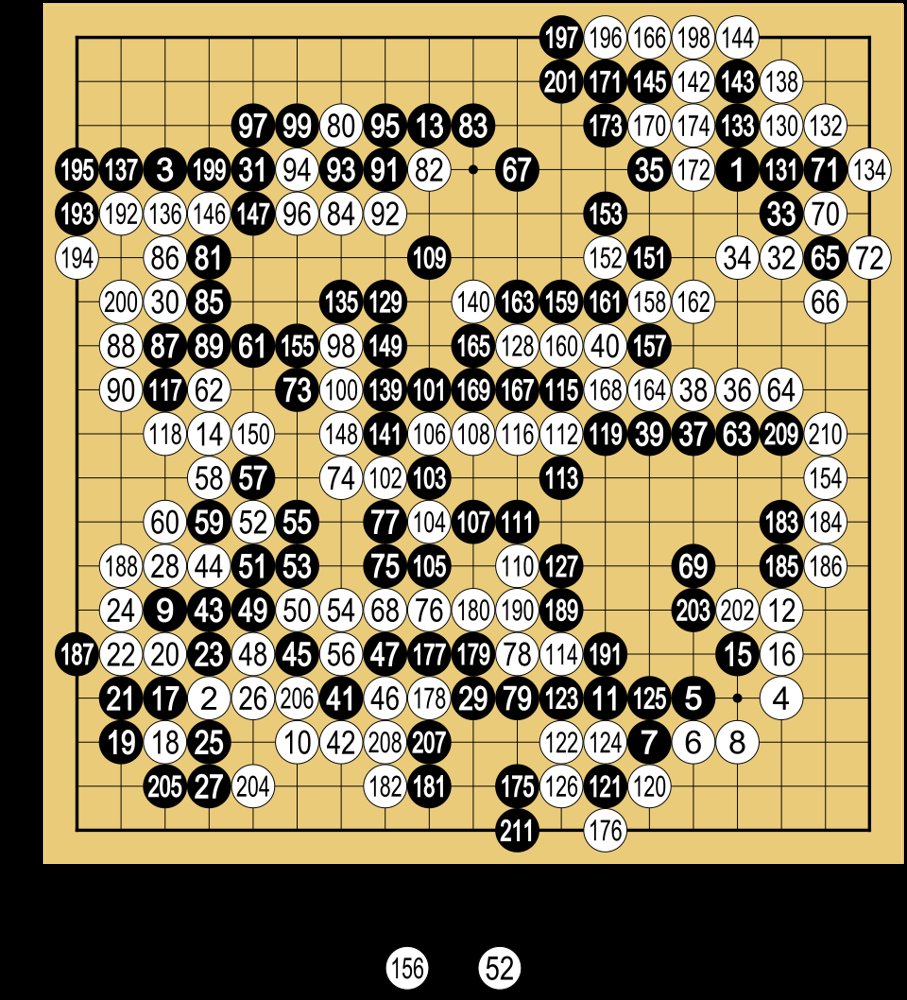
2016 年 3 月,AlphaGo 與李世乭在首爾進行五番棋,最後以 4 比 1 獲勝。圍棋之所以被視為 AI 的難關,在於可能的盤面數比宇宙中的原子還多。深藍下西洋棋時靠的是暴力搜尋,也就是把可能的走法盡量算過一遍,這種做法放到圍棋上完全行不通。
AlphaGo 的解法是結合深度神經網路+強化學習+樹狀搜尋。神經網路像棋士的直覺,判斷哪些位置值得考慮、目前局勢對誰有利;強化學習讓它從對局的輸贏中不斷改進;樹狀搜尋則只針對少數有希望的走法往下推演,不必窮舉所有可能。
比賽中有兩手棋特別有名。第二局第 37 手,AlphaGo 下出人類棋士認為「不會有人這樣下」的一步,事後被視為妙手。第四局,李世乭下出被稱為「神之一手」的第 78 手,贏下人類在這場比賽中唯一的一局。
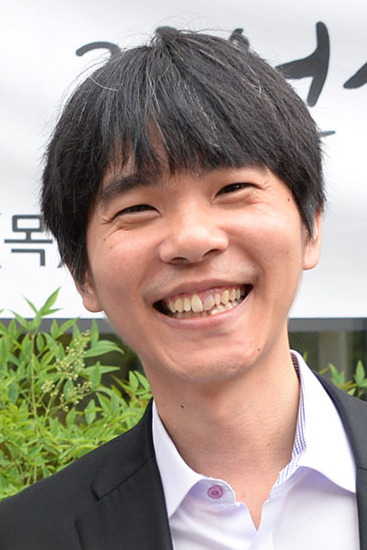
李世乭
Lee Sedol1983 年生
李世乭是韓國圍棋九段,曾十八次奪得世界冠軍,是當時最具代表性的頂尖棋士之一。2016 年輸給 AlphaGo 之後,他說:「輸的是李世乭,不是人類。」這句話把敗局攬在自己身上,也表達出人類不該就此認輸的態度。
三年後,他的看法有了轉變。2019 年他宣布退休,表示 AI 是「無法被打敗的存在」。對一位以勝負為職業的棋士來說,這意味著比賽的意義已經不同。
他在第四局拿下的那一勝,至今仍是人類對頂尖圍棋 AI 少數的勝局之一。這段經歷也引出更大的問題:當 AI 在某個領域超越人類,人類的學習方式與價值會如何改變。圍棋界後來的回應是大量用 AI 學棋,把它從對手變成老師。
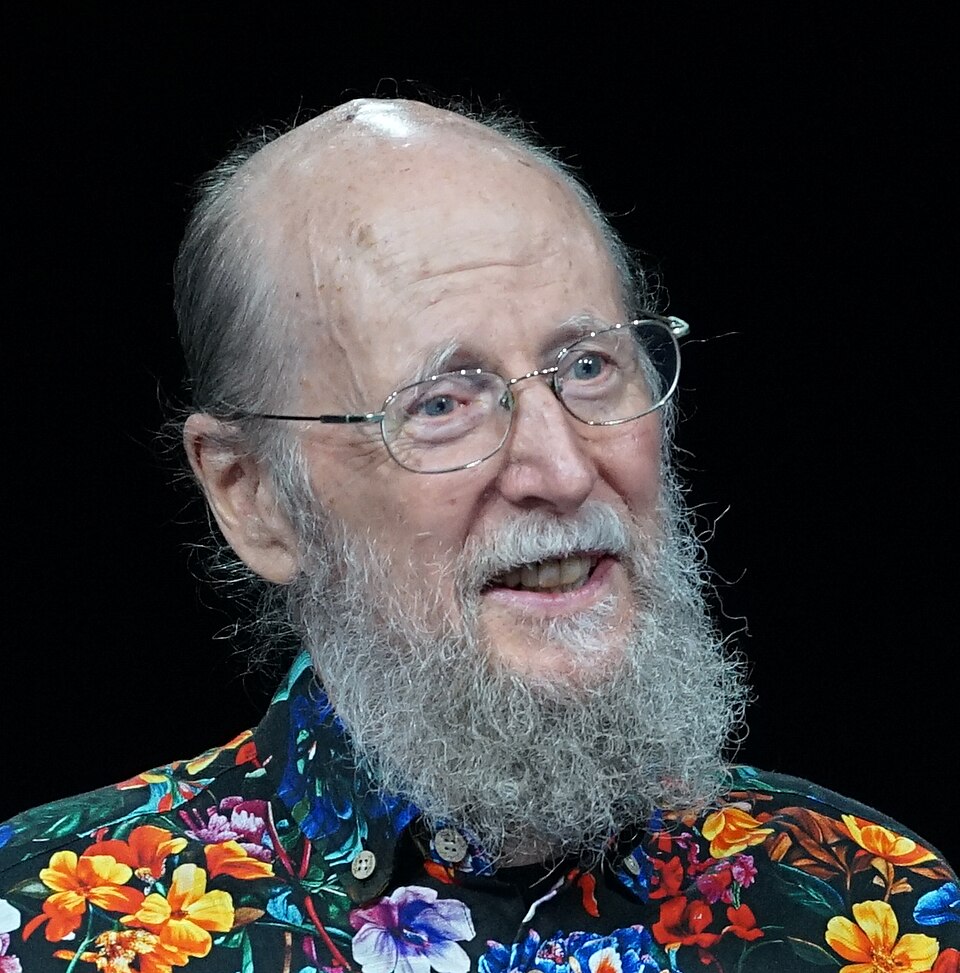
理查·薩頓
Richard Sutton1950 年代生
薩頓是強化學習的奠基者之一,與巴托(Andrew Barto)合著的教科書是這個領域的經典。強化學習(reinforcement learning)讓 AI 透過「嘗試、獲得獎勵或懲罰、再調整」的循環來學習,有點像用獎勵鼓勵寵物學會正確動作;AlphaGo 從對局輸贏中改進棋力,也是同樣的道理。
2019 年,他發表短文〈苦澀的教訓〉,主張長期來看,能善用大量算力的通用方法,總是勝過研究者精心設計、把人類知識寫進系統的做法。之所以「苦澀」,是因為研究者投入心血的巧思,最後往往被單純擴大規模的方法超越。
這個觀點可以當作 AlexNet 與 GPT 共同的註腳:在這些轉折點上,規模與算力一再勝出。2025 年 3 月,他與巴托共同獲得 2024 年度圖靈獎的消息正式公布。
七十年 AI 研究最大的教訓是:利用計算的通用方法,最終是最有效的,而且差距很大。
2017:Transformer 誕生
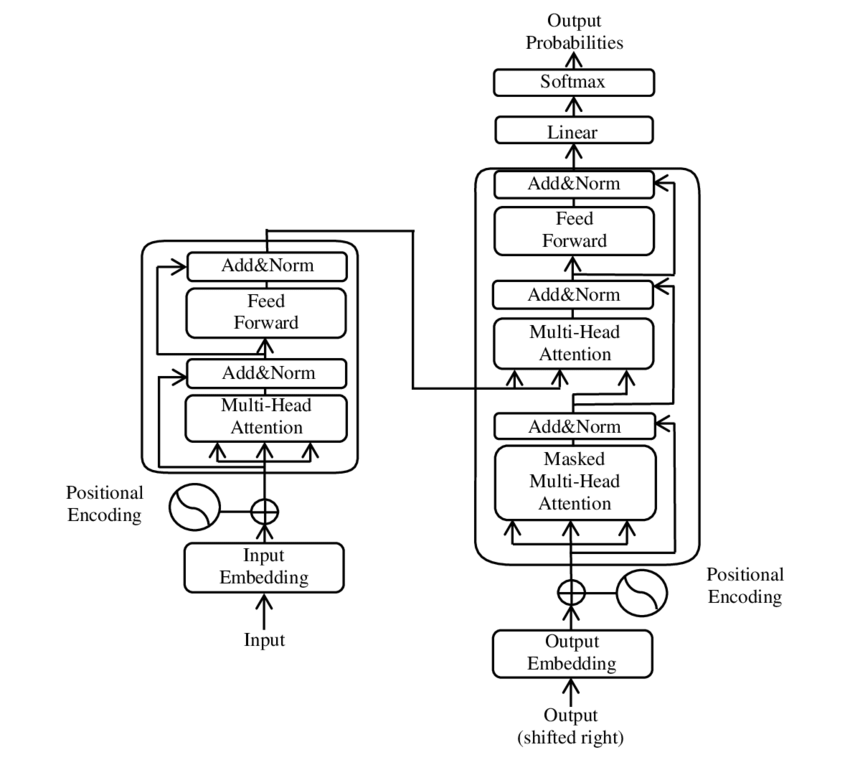
2017 年,Google 的八位研究者發表論文〈Attention Is All You Need〉,提出 Transformer 架構。它的核心是「注意力」機制:模型在讀一個字時,會同時看句子裡所有其他字,判斷哪些字彼此有關。
在此之前,處理文字常用 LSTM 這類模型,它必須一個字一個字依序讀,前一個字沒處理完,就不能處理下一個,速度因此受限。Transformer 不必依序處理,整句話的字可以同時計算,所以非常適合 GPU 平行運算。AlexNet 證明了 GPU 的價值,Transformer 則把 GPU 的平行算力用到極致,這是它勝出的一大原因。
Transformer 原本是為機器翻譯而設計,後來卻成為 GPT、BERT、Claude、Gemini 等幾乎所有大型語言模型的基礎。GPT 名稱裡的「T」,指的就是 Transformer。
注意力機制:用一句話理解
看這個句子:「小明把蛋糕放進冰箱,因為它太熱了。」這裡的「它」指的是蛋糕還是冰箱?人類一看就知道是蛋糕,因為我們明白太熱的東西才需要放進冰箱。但對模型來說,「它」只是一個字,必須另外想辦法找出它跟誰有關。
注意力機制的做法,是計算「它」和句子裡每一個字的關聯程度,關聯越高,分配到的「注意力」就越多。訓練良好的模型會讓「它」與「蛋糕」「熱」之間的關聯特別高,因而理解句子的意思。
Transformer 對句子裡的每一個字都同時做這件事,而且一層疊一層地反覆進行。前面的層可能只抓到簡單的詞語搭配,後面的層再以此為基礎,組合出更複雜的關係。疊了很多層之後,模型就能掌握語法、語意,甚至常識。
生成式 AI 時代
2018 – 2026
從預測下一個字,到會寫、會畫、會推理、會行動
語言模型的核心:預測下一個字
今天的大型語言模型,核心任務其實出奇單純:讀一段文字,猜下一個字是什麼。給它「今天天氣很」,它要判斷接下來最可能是「好」「熱」還是「冷」,並為每個候選字給出機率。這個想法並不新,早在 1948 年,夏農就用機率來預測英文字母的出現順序。
真正改變的是規模。研究者把這個猜字任務放到網路上幾乎所有文字上反覆訓練。為了猜得準,模型不能只記住常見搭配,它得掌握句子怎麼組成、世界上的事實是什麼、前因如何導出後果,於是語法、知識與推理的模式,都在猜字的過程中被一併學了進去。
夏農的機率想法、Transformer 架構,以及伊爾亞「資料越多、模型越大,它就越聰明」的信念,三條線在這裡匯流,成為生成式 AI 時代的起點。
GPT 的演進
2022 年 11 月 30 日:ChatGPT 上線
ChatGPT 上線時,OpenAI 原本只把它當成一次「研究預覽」,想看看一般人會怎麼使用。結果反應遠超預期:五天內使用者突破 100 萬,約兩個月就達到 1 億月活躍使用者,被認為是當時成長最快的消費級應用程式。
讓它能像樣地對話的關鍵技術之一,是人類回饋強化學習(RLHF)。只靠預測下一個字訓練出來的模型,懂得很多卻不一定會好好回答問題;RLHF 的做法是請人類評分員比較、評分模型的回答,再用這些評分調整模型,讓它學會哪種回覆比較有幫助、比較得體。
這也提醒我們,看似全自動的 AI 背後,仍有大量人力。就像當年 ImageNet 仰賴眾多標註者,RLHF 同樣需要許多人類評分員。從這一刻起,AI 第一次真正走進一般人的日常。
生成式 AI 時代的關鍵人物
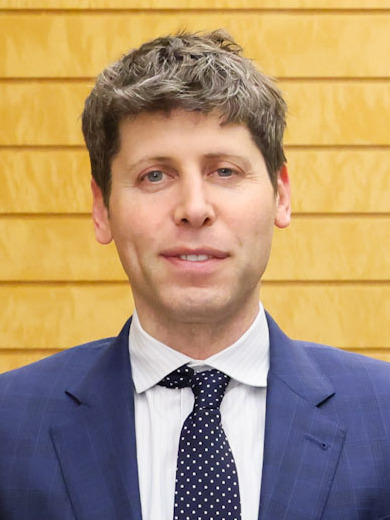
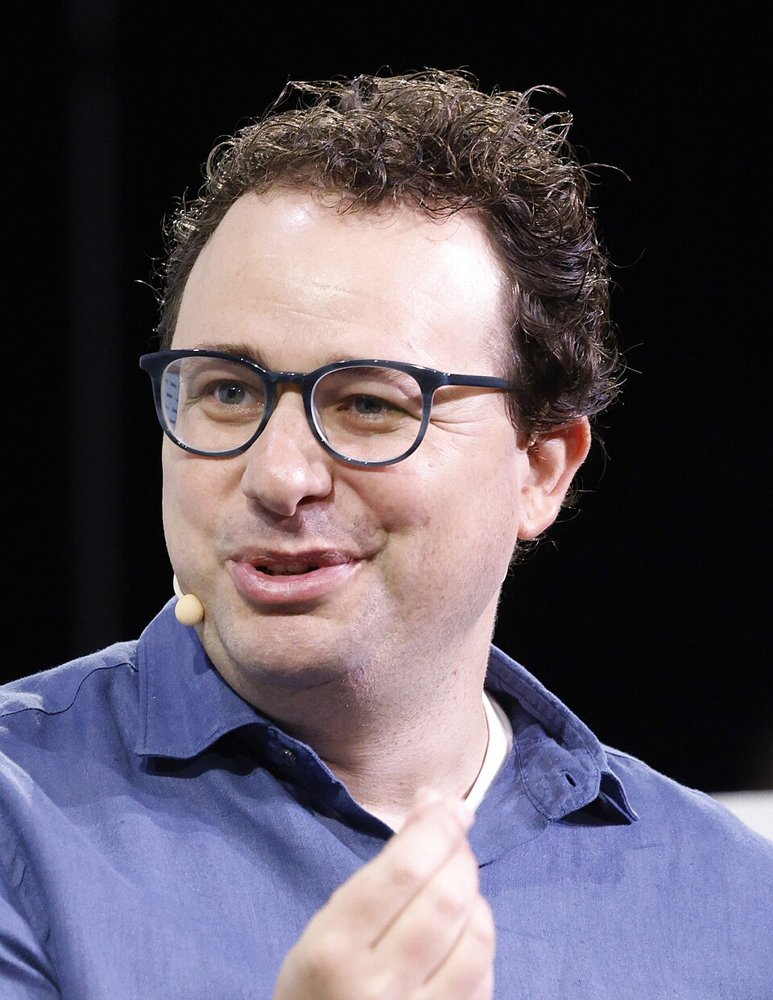
2021 年,多位前 OpenAI 研究者創辦 Anthropic;2023 年,Google Brain 與 DeepMind 合併為 Google DeepMind。
不只是文字:會畫、會說、會看
生成式 AI 很快就跨出了文字的範圍。2021 年,OpenAI 發表 DALL·E,只要輸入一段文字描述就能生成圖片。到了 2022 年,Midjourney、Stable Diffusion 與 DALL·E 2 接連推出,掀起一波 AI 繪圖熱潮,背後的擴散模型也成為主流。擴散模型的概念是先學會把圖片一步步加上雜訊直到變成一片雜點,再反過來學習如何從雜點逐步去除雜訊、「顯影」出符合描述的畫面。
聲音方面,同樣在 2022 年,Whisper 語音辨識模型開源,讓任何人都能把語音轉成文字。2024 年,影片生成模型(如 Sora)展示了長達一分鐘的生成影片。
同一年,另一個重要方向是多模態:把語音、圖片、文字整合在同一個模型裡。過去聽、看、寫各由不同系統負責,多模態模型則能在同一次對話中同時理解一張照片、一段話與一串文字。
AI 走進科學:AlphaFold
蛋白質是由胺基酸串成的長鏈,會摺疊成複雜的立體結構,而這個形狀決定了它在生物體內的功能。過去要用實驗解出一個蛋白質的結構,可能得花上好幾年,這使得結構知識長期是生物學研究的瓶頸。
2020 年,DeepMind 的 AlphaFold 2 在國際蛋白質結構預測競賽中,達到接近實驗的準確度,等於讓電腦直接從胺基酸序列推算出立體形狀。之後團隊公開預測了約 2 億種蛋白質結構,供全世界研究者免費使用,許多實驗室因此省下大量時間。
2024 年,哈薩比斯與 Jumper 因這項成果,與 David Baker 共同獲得諾貝爾化學獎;同一年,辛頓與霍普菲爾德獲得諾貝爾物理學獎。AI 一年拿下兩座諾貝爾獎,象徵它已從工程工具,成為推動基礎科學的力量。
2023–2026:越來越快
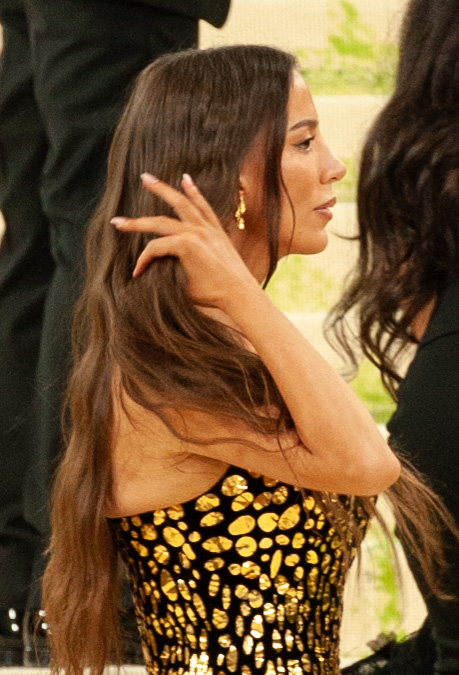
米拉·穆拉蒂
Mira Murati1988 年生
穆拉蒂曾任 OpenAI 技術長,帶領 ChatGPT、DALL·E 等產品上線,是生成式 AI 從實驗室走向大眾的關鍵推手之一。2024 年她離開 OpenAI,2025 年創辦了自己的公司 Thinking Machines Lab。
她的動向反映了這個時代的一個現象:頂尖人才不斷離開大公司、另起爐灶。在 AI 領域,少數核心研究者與工程師的經驗,往往就是一家新公司最重要的資本,因此人才流動本身就會改變產業版圖。
這場人才爭奪並不是近年才開始。回到 2012 年 DNNresearch 的競標;從那時起,各方搶人的競爭從未停止,穆拉蒂的創業只是其中最新的一頁。
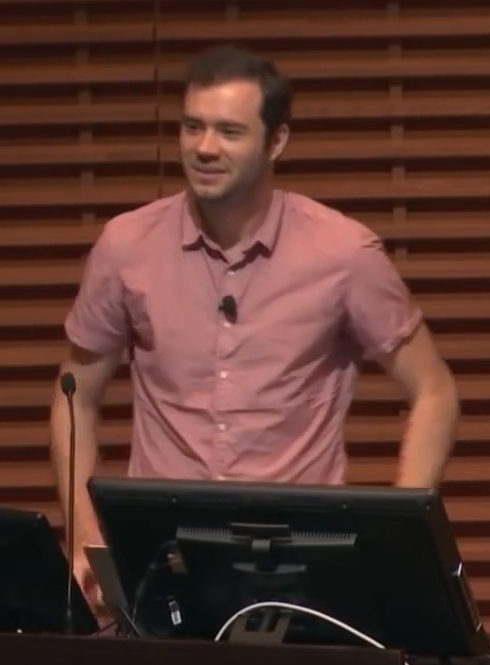
安德烈·卡帕西
Andrej Karpathy1986 年生
卡帕西是李飛飛在史丹佛的博士生,曾參與 ImageNet 相關研究,親身經歷了深度學習在電腦視覺上的突破。後來他成為 OpenAI 的創始成員之一,也曾擔任特斯拉的 AI 總監,負責把研究成果帶進真實產品。
除了研究與產業工作,他長期製作免費的深度學習教學影片,從基礎原理一步步講解神經網路如何運作,影響了許多沒有正式修課、靠自學入門的人。
從他身上可以看到 AI 史的師承脈絡:辛頓帶出伊爾亞,李飛飛帶出卡帕西。他們屬於 AlexNet 這條線的「第二代」,是學生的學生,如今正在定義今天的 AI。從這個角度看,AI 的發展也是一部師生傳承史。
生成式 AI 帶來的新問題
生成式 AI 的能力越強,引發的問題也越具體。首先是幻覺:模型的任務是產生「看起來合理」的文字,而不是查證事實,因此它可能自信地說出不存在的事實,甚至捏造引用文獻。其次是著作權:模型用網路上大量作品訓練,創作者的權益該如何保障,仍有爭議。
偏見也是一大課題。訓練資料若帶有刻板印象,模型會把它學走,甚至放大。深偽技術則能做出以假亂真的影像與聲音,讓假訊息更難辨識。
此外,訓練大模型需要龐大電力,算力也集中在少數公司手中,引發能源與權力集中的疑慮。在教育與工作上,當 AI 能寫報告、解題,作業、考試與職業技能的意義都在改變。2023 年,辛頓離開 Google,正是為了能公開談論這些風險。
2026 年 9 月:黃仁勳談 AI 時代的工程師與學生
2026 年 9 月 23 日,《紐約時報》Podcast《The Ezra Klein Show》播出一集約 1 小時 48 分的訪談,來賓是黃仁勳,單集標題為「Jensen Huang Thinks A.I. Alarmism Has Gone Too Far」,意思是他認為對 AI 的危言聳聽已經過頭。
訪談中,主持人克萊因點出一個現象:資深工程師的職缺在增加,初階工程師的職缺卻在減少。他接著直接發問:「我們還需要那些初階工程師嗎?」這個問題背後的憂慮是,如果入門工作被 AI 取代,新人要從哪裡累積經驗。
這段對話之所以值得放進 AI 發展史,在於說話者的身分:十四年前替 AlexNet 提供顯示卡的公司,如今由他擔任執行長。這家公司的執行長怎麼看 AI 對學習的影響,是理解這個時代的一個切面。
再等兩年。因為念大學要四年,這項新技術離第一批人畢業,平均還要兩年。所以兩年後,你會看到新一代的工程師、學生和藝術家……再過幾年,AI 原生的新鮮人畢業生——天啊,會有一波了不起的工程師出現。
— 黃仁勳,The Ezra Klein Show,2026-09-23(中文為本課翻譯)
現在試著叫一個小孩做長除法看看。九九乘法表開始被遺忘了……基礎數學正在被遺忘。
— 黃仁勳,The Ezra Klein Show,2026-09-23(中文為本課翻譯)
我們會失去一些比較細緻的智力靈巧度,但我們會成為更好的系統思考者。今天的工程師,系統思考能力比我剛畢業時好得多;但當年的我,是好得多的電晶體思考者。
— 黃仁勳,回應「基礎數學被遺忘重不重要?」——「我不認為重要。」
怎麼看黃仁勳的說法?
支持黃仁勳觀點的理由,來自工程史的經驗。計算機普及後,手算開根號不再是必備技能,工程師轉而處理更大的問題;早在 1980 年,美國全國數學教師協會(NCTM)就建議各年級善用計算機。抽象層級往上移是常態,從電晶體、晶片、系統,到今天的 AI Agent,每一代都站在前一代的工具上。他自己也舉例:今天的工程師更懂系統,他當年則更懂電晶體。
但這些說法也有值得追問之處。沒有基礎,怎麼抓錯?不會估算的人,可能看不出 AI 算錯了一個數量級,這正是 ELIZA 效應的提醒:機器的回應看起來流暢可信,人就容易高估它的能力,但流暢不代表正確。其次,「AI 原生畢業生會更強」是預測,不是已發生的事實,兩年後可以回來檢驗。
也要考慮說話者的立場:AI 晶片公司的執行長對 AI 抱持樂觀,是可以預期的。對照辛頓,同一個故事裡的兩個人,一個離開 Google 去示警,一個認為危言聳聽過頭了。重點不在選邊,而是同時看見一段話的道理與它的限制。
支持的理由
- 歷史上一再發生:計算機普及後,手算開根號不再是必備技能,工程師轉而處理更大的問題
- 1980 年,美國全國數學教師協會(NCTM)就建議各年級善用計算機
- 抽象層級往上移是工程史的常態:從電晶體 → 晶片 → 系統 → AI Agent
- 他自己的例子:今天的工程師更懂系統,他當年更懂電晶體
值得追問的地方
- 沒有基礎,怎麼抓錯?不會估算的人,看不出 AI 算錯了一個數量級——回想 ELIZA 效應
- 「AI 原生畢業生會更強」是預測,不是已發生的事實;兩年後可以回來檢驗
- 考慮說話者的立場:AI 晶片公司的執行長,對 AI 抱持樂觀是可以預期的
- 對照辛頓:同一個故事裡的兩個人,一個離開 Google 去示警,一個認為危言聳聽過頭了
黃仁勳說:基礎數學被遺忘,「我不認為重要」。
你同意嗎?哪些基礎能力,在 AI 時代反而更重要?
提示:想想你要怎麼判斷 AI 的答案是對是錯。估算、閱讀原始資料、寫出自己的推理……
今天的課,我們查核了一篇看起來很可信的 AlexNet 故事,
發現有誇大、也有找不到出處的句子。
如果是 AI 寫的文章,你會怎麼查核?
步驟建議:找原始來源 → 區分事實與詮釋 → 注意數字與引語 → 標記單一來源。
回顧:從這段歷史學到什麼
兩千年的 AI 史,一張表
模式一:好想法常常要等條件成熟
回顧 AI 的歷史,有一個反覆出現的模式:好想法往往比實現它的條件早了好幾十年。
巴貝奇的分析機是最早的例子。它的設計在原理上是正確的,但當時的工藝做不出這台機器,要等到 150 年後的工藝水準,才造得出來。神經網路也是如此:1943 年就有了理論,1986 年有了訓練方法,卻要到 2012 年,才等到足夠的資料與算力,真正展現威力。
Transformer 的故事也類似。它的核心「注意力機制」,簡單說就是讓模型判斷一段文字中哪些部分彼此最相關,這個想法早已存在;直到 GPU 的運算能力與網路資料的規模都足夠,才爆發成 ChatGPT。這提醒我們,一個想法暫時行不通,未必是想法錯了,也可能只是條件還沒成熟。
巴貝奇
分析機的設計正確,但要等 150 年後的工藝才造得出來。
神經網路
1943 年就有理論,1986 年有訓練方法,2012 年才等到資料與算力。
Transformer
注意力機制早已存在,直到 GPU 與網路資料規模足夠,才爆發成 ChatGPT。
模式二:熱潮與寒冬會循環
AI 的發展從來不是一路直線上升,而是熱潮與寒冬交替。所謂「寒冬」,指的是期望落空之後,資金與關注大幅退潮的時期。
1960 年代,有人樂觀地宣稱「二十年內機器能做任何人的工作」,承諾無法兌現,便迎來第一次寒冬。1980 年代,專家系統與 Lisp 機器(專門執行 Lisp 這種 AI 程式語言的電腦)掀起商業熱潮,泡沫破裂後,進入第二次寒冬。
每次循環的劇本都很相似:技術展現出驚人的成果,期待隨之膨脹到超出技術的實際能力,接著是失望與退場。2020 年代的生成式 AI 熱潮,這次會不一樣嗎?還是需要更謹慎的期待?歷史無法直接給出答案,但它提醒我們,在興奮之餘保留一點冷靜。
1960 年代
「二十年內機器能做任何人的工作」→ 第一次寒冬。
1980 年代
專家系統與 Lisp 機器的商業泡沫 → 第二次寒冬。
2020 年代
生成式 AI 熱潮:這次會不一樣嗎?還是需要更謹慎的期待?
模式三:重要的東西,一開始都不起眼
許多後來改變世界的東西,剛出現時都不被看好,甚至被當成失敗。
被冷落的理論:神經網路在 2000 年代被視為死胡同,後來卻成為 AI 突破的核心。沒人消化得了的資料:ImageNet 是一個大型的標註圖片資料集,頭兩年進步緩慢,連創辦人都懷疑它的價值,因為當時的方法還無法善用這麼龐大的資料。
打電動的顯示卡:顯示卡原本為遊戲畫面而設計,NVIDIA 推出 CUDA,讓顯示卡也能拿來做一般運算,但推出時市場不買單,股價還因此重挫。後來,正是顯示卡擅長的大量平行運算,撐起了神經網路的訓練。
理論、資料、算力,這三樣東西各自看來都不起眼,湊在一起時,卻正是神經網路在 2012 年翻身所需要的條件。
被冷落的理論
神經網路在 2000 年代被視為死胡同。
沒人消化得了的資料
ImageNet 頭兩年進步緩慢,連創辦人都懷疑。
打電動的顯示卡
CUDA 推出時市場不買單,NVIDIA 股價重挫。
模式四:AI 背後一直有人
AI 看起來像是機器自己變聰明,但從歷史來看,它的背後一直有人。
土耳其行棋傀儡是 1770 年的一台「下棋機器」,表面上會自己下棋,實際上櫃子裡藏著一位棋手。這是最直接的例子:觀眾以為看見了機器的智慧,其實是人的智慧被藏了起來。
到了現代,人的參與變得更隱形,卻從未消失。ImageNet 的圖片,是由近五萬名群眾外包工作者一張一張標註而成;機器之所以認得出圖片內容,是因為有人先告訴它答案。ChatGPT 懂得「好好回話」,則仰賴大量人類評分員的回饋,告訴模型哪些回答比較好。
換句話說,AI 不是憑空出現的智慧,而是無數人的勞動、資料與判斷的累積。
土耳其行棋傀儡
1770 年,櫃子裡藏著一位棋手。
ImageNet
近五萬名群眾外包工作者,一張一張標註圖片。
ChatGPT
大量人類評分員的回饋,教會模型「好好回話」。
臺灣在 AI 史上的位置
AlexNet 用的 GTX 580、今天訓練大型語言模型的 GPU,晶片多由台積電製造。
給正在使用 AI 的你
歷史的價值,在於幫助我們面對眼前的選擇。對每天使用 AI 的人來說,前面這些故事可以濃縮成幾種態度。
首先是保持好奇,也保持懷疑。今天被冷落的想法,可能就是明天的突破,神經網路就是例子;但「十年內」「毫無疑問」這類斬釘截鐵的說法,在歷史上也常常落空。好奇讓我們不錯過新的可能,懷疑讓我們不被誇大的承諾牽著走。
其次是查核來源。連好看的科技故事都可能有誇大,AI 的回答更需要查證,不能因為說得流暢就照單全收。同時也要看見背後的人:資料、標註、評分、能源,每一環都有人在付出代價。
最後是動手去做。艾力克斯不是最有名的那個人,但他是把程式寫出來的人。理解 AI 最好的方式,往往不是旁觀,而是親自嘗試。
如果五十年後,有人寫「2026 年的 AI 史」,
你覺得哪一件今天看起來不起眼的事,會被寫成轉捩點?
請在 Uedu 討論區留下你的預測與理由(100 字以內)。
世界改變之前,
真正重要的東西,
往往看起來都不像重要的東西。
附錄
延伸閱讀與圖片授權
延伸閱讀
- Cade Metz(2021)。《Genius Makers: The Mavericks Who Brought AI to Google, Facebook, and the World》。Dutton。(中譯本《AI 製造商沒說的祕密》)
- 李飛飛(2023)。《The Worlds I See》。Flatiron Books。(中譯本《我看見的世界》)
- Krizhevsky, A., Sutskever, I., & Hinton, G. E. (2012). ImageNet classification with deep convolutional neural networks. NeurIPS 25.
- Turing, A. M. (1950). Computing machinery and intelligence. Mind, 59(236), 433–460.
- Vaswani, A., et al. (2017). Attention is all you need. NeurIPS 30.
- Sutton, R. (2019). The Bitter Lesson. incompleteideas.net
- Weizenbaum, J. (1966). ELIZA. Communications of the ACM, 9(1), 36–45.;Weizenbaum, J. (1976). Computer Power and Human Reason.
- Chalmers, D. (2023). Could a large language model be conscious? Boston Review.;Nagel, T. (1974). What is it like to be a bat? The Philosophical Review, 83(4).
- Hofstadter, D. (1995). Fluid Concepts and Creative Analogies.;Reeves & Nass (1996). The Media Equation.;Bender et al. (2021). Stochastic parrots. FAccT.
- Melanie Mitchell(2019)。《Artificial Intelligence: A Guide for Thinking Humans》。
本次史實查核主要來源
- Computer History Museum(2025)。CHM Releases AlexNet Source Code。computerhistory.org
- IEEE Spectrum(2025)。How AlexNet Transformed AI and Computer Vision Forever。
- Forbes(2026-05-13)。Nvidia Hits Record $5.5 Trillion Value—First Company To Ever Reach Mark。
- AMD Investor Relations(2026-09-28)。AMD to Acquire World Labs to Advance the Future of AI Compute。
- TechCrunch、Fortune(2026-09-28)。AMD will acquire Fei-Fei Li’s World Labs for $8.2B。
- The Ezra Klein Show(2026-09-23)。Jensen Huang Thinks A.I. Alarmism Has Gone Too Far。The New York Times。
- The New Stack(2026-09)。Jensen Huang says the junior developer problem ends in two years;Zvi Mowshowitz(2026-09-25)。On Ezra Klein’s Podcast With Jensen Huang。
- Wikipedia 各人物條目(交叉比對生卒年與事件年份)
圖片來源與授權(1/10)
所有圖片取自 Wikimedia Commons,依各自授權條款使用(公眾領域、CC0、CC BY、CC BY-SA)。
圖片來源與授權(2/10)
所有圖片取自 Wikimedia Commons,依各自授權條款使用(公眾領域、CC0、CC BY、CC BY-SA)。
圖片來源與授權(3/10)
所有圖片取自 Wikimedia Commons,依各自授權條款使用(公眾領域、CC0、CC BY、CC BY-SA)。
圖片來源與授權(4/10)
所有圖片取自 Wikimedia Commons,依各自授權條款使用(公眾領域、CC0、CC BY、CC BY-SA)。
圖片來源與授權(5/10)
所有圖片取自 Wikimedia Commons,依各自授權條款使用(公眾領域、CC0、CC BY、CC BY-SA)。
圖片來源與授權(6/10)
所有圖片取自 Wikimedia Commons,依各自授權條款使用(公眾領域、CC0、CC BY、CC BY-SA)。
圖片來源與授權(7/10)
所有圖片取自 Wikimedia Commons,依各自授權條款使用(公眾領域、CC0、CC BY、CC BY-SA)。
圖片來源與授權(8/10)
所有圖片取自 Wikimedia Commons,依各自授權條款使用(公眾領域、CC0、CC BY、CC BY-SA)。
圖片來源與授權(9/10)
所有圖片取自 Wikimedia Commons,依各自授權條款使用(公眾領域、CC0、CC BY、CC BY-SA)。
圖片來源與授權(10/10)
所有圖片取自 Wikimedia Commons,依各自授權條款使用(公眾領域、CC0、CC BY、CC BY-SA)。